Список голосов Speech Synthesis: безопасная диагностика
Как разбирать пустой список голосов, выбирать язык, управлять очередью речи и ошибками, не считая голоса сигналом личности.
BotBrowser Team
Нужна поддерживаемая продуктовая документация?
У этой статьи есть соответствующая страница в центре документации. Используйте docs для каноничного сценария настройки, актуальных флагов и долгосрочной справки.
Режим профиля BotBrowser контролирует доступные метаданные голосов, но не гарантирует, что хост сможет воспроизвести слышимую речь.
Если в браузере список голосов пуст, не спешите считать API неподдерживаемым и не опрашивайте его бесконечно. Прочитайте результат getVoices(), подпишитесь на voiceschanged для ограниченного по времени обновления, а если подходящий голос не появится, сохраните доступный текст и предложите повторную попытку или переход к языку приложения. Начинайте воспроизведение только после осознанного действия пользователя, сопоставляйте выбранный голос с текущим списком и обрабатывайте завершение очереди, отмену и ошибки как обычные состояния приложения. Метаданные доступных голосов могут меняться, поэтому они не являются устойчивой идентичностью устройства или единым каталогом для разных операционных систем.
Кратко
- В конкретный момент
getVoices()может вернуть пустой массив. Считайте это состоянием загрузки или доступности и обновите данные послеvoiceschanged; не предполагайте фиксированное число событий или время их появления. name,lang,localService,defaultиvoiceURIотвечают на разные вопросы. Выбирайте голос под задачу читателя и его язык, а не исходя из предполагаемого порядка голосов операционной системы.speak()добавляет высказывание в очередь речи. Обновление списка не повод снова добавлять туда то же высказывание: обновите выбор и дайте читателю решить, запускать ли речь или повторить её.- Запускайте воспроизведение явным действием пользователя, но не обещайте одинаковый запрос разрешений или политику активации во всех браузерах. Сохраняйте исходный текст и состояние ошибки, из которого можно повторить попытку.
- Список голосов может раскрыть контекст среды, но не устанавливает личность человека. Собирайте только необходимые диагностические данные и не отправляйте полный перечень по умолчанию.
Содержание
- Что предоставляет API
- Правило выбора по каждому полю
- Дерево отказов голосового селектора
- Обновление списка и состояния очереди речи
- Запасной язык и активация пользователя
- Отмена, ошибки и границы приватности
- Что добавляет руководство по настройке
- Часто задаваемые вопросы
- Практическое заключение
Что предоставляет API
Web Speech API разделяет поиск голосов и произнесение текста. window.speechSynthesis является контроллером: он предоставляет текущий список голосов, очередь и методы вроде speak(), cancel(), pause() и resume(). SpeechSynthesisUtterance содержит текст и необязательные настройки одного запроса. Приложение может прочитать метаданные голосов до того, как попросит контроллер говорить; перечисление голосов само по себе не воспроизводит аудио. Для чтения списка через getVoices() API не предусматривает отдельного запроса разрешения пользователя; правила запуска воспроизведения аудио рассматриваются отдельно.
Список зависит от контекста и не является универсальным. Браузер может использовать службы речи операционной системы, службу самого браузера или обе. На доступные голоса могут влиять установленные языковые ресурсы и решения браузера. Даже на одном устройстве разные браузеры или их версии не обязаны возвращать одинаковый набор. Список также может измениться после установки языкового пакета или службы. Поэтому не публикуйте таблицу с утверждением, что для каждой установки Windows, macOS, Linux или мобильной системы существует фиксированное число, марка, порядок или набор названий голосов.
Первый вызов не является надёжной проверкой готовности. В документации MDN указано, что getVoices() возвращает голоса, доступные службе синтеза в данный момент, а событие voiceschanged сообщает об изменении списка. В одних средах приложение сначала видит пустой список, а затем событие изменения; в других записи доступны уже при первом чтении. API не задаёт универсальную задержку, после которой список обязательно станет полным. Страница должна поддерживать как немедленный список, так и последующее обновление, не превращая конкретный момент появления данных в гарантию совместимости.
Эта поверхность важна для приватности, поскольку названия, языковое покрытие, признаки локальности и поведение обновлений могут дополнять другие сигналы браузера. О более общей идее объединения разных атрибутов браузера рассказано в статье что такое отпечаток браузера. Сам факт, что набор может быть отличительным, не доказывает, что сайт его использует, что он идентифицирует человека или что какое-либо свойство однозначно указывает на операционную систему. Пользовательскому селектору голосов нужны только сведения, помогающие сделать выбор; обычной аналитике редко требуется полный список.
Правило выбора по каждому полю
У объектов голосов есть поля с разными назначениями. Удобный селектор не считает их взаимозаменяемыми идентификаторами.
| Поле | Полезный вопрос приложения | Правило выбора | Чего не следует выводить |
|---|---|---|---|
lang | Какой язык или региональный вариант представлен? | Сравните языковые теги с запрошенной локалью приложения: сначала точное совпадение, затем намеренно выбранная альтернатива на уровне языка. | Совпадение тега не гарантирует, что текст переведён или будет произнесён ожидаемым образом. |
name | Какая подпись поможет человеку различать варианты? | Если требуется выбор, покажите короткую экранированную подпись; храните её локально, если поддержке не нужно иное. | Название, похожее на бренд, не доказывает тип ОС, устройства или личность человека. |
localService | Описывает ли API службу как локальную? | Используйте это поле только при наличии пользовательской причины объяснить работу локальной или удалённой службы. | Значение true не обещает приватность сети или успешное воспроизведение. |
default | Какой голос реализация помечает как используемый по умолчанию? | Если человек ещё не выбрал голос, используйте это значение для разрешения ничьей между подходящими вариантами. | Голос по умолчанию не обязательно соответствует предпочитаемому языку приложения или лучше подходит к текущему тексту. |
voiceURI | Предоставляет ли реализация URI голоса? | Считайте его непрозрачным значением; не сохраняйте его и не используйте как ключ между сеансами. | Не гарантируется глобальная стабильность, переносимость или смысл вне конкретной реализации. |
Таблица помогает принять решение, а не описывает сигнатуры платформ. В одной системе name может быть понятной подписью, а в другой идентификатор окажется непрозрачным; приложению не следует разбирать имя, чтобы вывести поставщика. Значение localService описывает объект голоса согласно реализации, а не весь маршрут каждого запроса речи. Аналогично, default выражает предпочтение реализации, а не алгоритм согласования языка для страницы.
Начните с реального требования приложения. Если нужно читать испанский текст, выбирайте из голосов с lang, наиболее точно соответствующим запрошенному варианту испанского языка в текущем списке. Если совпадений несколько, используйте явный выбор пользователя или предсказуемое правило, например default. Если странице нужна только кнопка воспроизведения без меню голосов, возможно, названия вообще не нужно отображать или сохранять. О том, как учитывать заявленные свойства платформы в контексте, читайте в статье свойства navigator и контекст платформы; ни одну из этих поверхностей не следует использовать как ключ личной идентичности.
Не полагайтесь на стабильный порядок вроде «голос с индексом ноль считается системным по умолчанию» или «первая английская запись одинакова на всех компьютерах». Порядок массива не является переносимым контрактом выбора. Обновление тоже может вернуть новый массив, поэтому приложению следует сохранять понятное пользователю предпочтение, например запрошенный язык или выбранный локально вариант, а затем искать ему соответствие среди последних объектов. Если прежний голос исчез, сообщите об этом и предложите доступные варианты вместо незаметного выбора постороннего голоса.
Дерево отказов голосового селектора
Следующий порядок решений помогает приложению оставаться полезным, не превращая временное состояние API в утверждение о браузере или устройстве:
- Доступен ли
speechSynthesis? Если нет, оставьте текст на странице и сообщите, что чтение вслух недоступно в текущем контексте. Не скрывайте и не заменяйте текст. - Возвращает ли
getVoices()записи сейчас? Если да, покажите варианты из текущего списка. Если нет, зарегистрируйте один обработчикvoiceschanged, перечитайте список после события и прекратите ожидание по тайм-ауту, заданному приложением. Не создавайте новый обработчик при каждом рендеринге. - Появился ли после обновления подходящий
lang? Если да, сохраняйте выбор пользователя, пока он остаётся подходящим. Если выбранный голос пропал, сбросьте устаревший выбор и объясните доступные альтернативы. Если совпадений нет, используйте явно заданный запасной язык приложения или предложите человеку выбрать; не угадывайте язык по названию голоса. - Запустил ли человек воспроизведение? Если да, создайте новое высказывание с текущим вариантом и вызовите
speak(). Если нет, ждите. Так функция остаётся под контролем читателя и не зависит от предположения об автоматическом воспроизведении. - Что произошло с высказыванием? При
endпокажите состояние ожидания или завершения. Приerrorвыведите краткое сообщение с возможностью повторить попытку и сохраните текст. При явной остановке отмените очередь и очистите активное состояние интерфейса. - Изменился ли список во время воспроизведения? Обновите селектор, но не дублируйте активное высказывание. Перед последующим повтором снова сопоставьте предпочтительный выбор с актуальным списком.
Пустой массив после ограниченного ожидания допускает несколько объяснений: синтез речи может быть недоступен в этом контексте, служба могла не предоставить записи, приложение ищет не ту локаль или инициализация не завершилась ожидаемым образом. Для этих случаев нужны разные действия пользователя. Общее сообщение «отпечаток не совпал» не полезно и ничем не обосновано. Формулировка «Сейчас голос для французского языка недоступен» подсказывает действие и не раскрывает весь список.
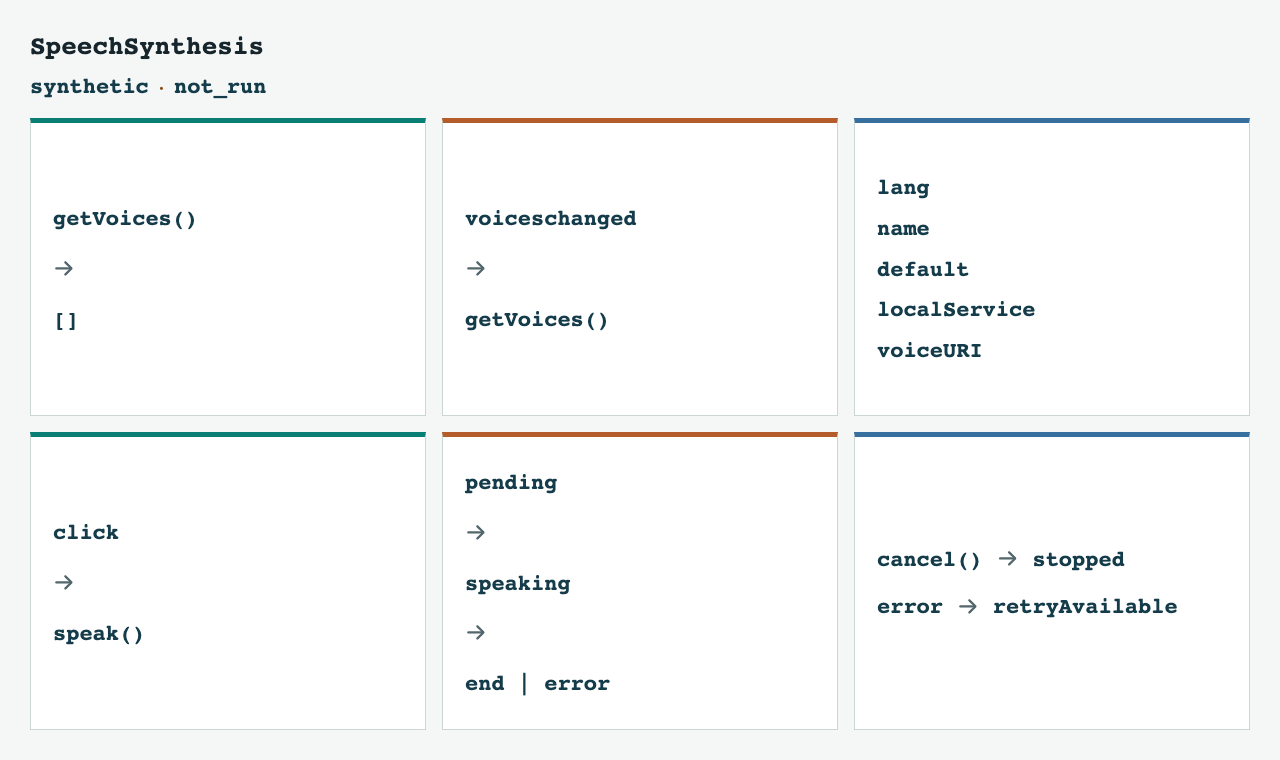
Схема отказов голосового селектора выше сводит эти ветви к шести состояниям приложения. Это иллюстративная схема для принятия решений, созданная из локального HTML-макета, а не снимок измерений браузера. Главный результат: интерфейс всегда сохраняет текстовый вариант, независимо от того, пришёл список сразу, изменился позже или остался пустым.
Как решить, что ожидание закончилось
| Признак, что список ещё загружается | Что это доказывает и чего не доказывает |
|---|---|
getVoices() вернул пустой массив при первой отрисовке | Само по себе не окончательно: список заполняется асинхронно |
voiceschanged ещё не сработал | Не окончательно: событие может ещё прийти |
После voiceschanged чтение непустое | Список готов к использованию |
| Тайм-аут истёк с пустым списком | За время ожидания голоса не появились; это не доказывает, что их нет |
Разница между «ещё нет» и «нет вообще» решает, покажет интерфейс индикатор загрузки, повторную попытку или сообщение о локали, а в одном вызове getVoices() оба случая выглядят одинаково. Три вопроса разделяют их без догадок.
Прочитайте один раз при загрузке и сохраните этот результат. Пустой массив при первой отрисовке нормален на части платформ, потому что список заполняется асинхронно. Запишите его как первый образец, а не как вердикт, и покажите селектор в состоянии загрузки.
Привяжите ровно один слушатель voiceschanged на время жизни компонента и перечитывайте список внутри него. Непустое чтение означает, что список готов. Совпадение с первым чтением говорит лишь о том, что событие сработало с пустым списком; платформа этого не гарантирует, поэтому записывайте «пока пусто», а не «голосов нет».
Ограничьте ожидание тайм-аутом приложения и считайте его состоянием, а не сбоем. Когда он истекает с пустым списком, снимите слушатель, очистите таймер, остановите индикатор и покажите сообщение о локали с читаемым текстом и кнопкой повтора. Страница, которая ждёт бесконечно или оставляет устаревший слушатель, превращает деталь платформы в нерабочий элемент управления.
const readOnce = () => speechSynthesis.getVoices();
const key = list => list.map(v => `${v.voiceURI}|${v.lang}|${v.name}`).join('\n');
let first = readOnce();
let settled = false;

const settle = new Promise(resolve => {
  const finish = outcome => {
    if (settled) return;
    settled = true;
    clearTimeout(timer);
    speechSynthesis.removeEventListener('voiceschanged', onChange);
    resolve(outcome);
  };
  const timer = setTimeout(() => finish('still-empty'), 2000);
  const onChange = () => {
    const next = readOnce();
    // A change event with the same list proves the event fired, not that the list is final.
    if (next.length) finish('ready');
    else if (key(next) !== key(first)) finish('still-empty');
  };
  speechSynthesis.addEventListener('voiceschanged', onChange);
  if (first.length) finish('ready');
  // If no event arrives, the 2 s timer reports 'still-empty': neither ready nor proven absent.
});
Три исхода ведут к трём разным экранам, и ни один из них не «синтез речи не поддерживается». Непустое первое чтение сразу ведёт к селектору. Позднее непустое чтение приводит к селектору после состояния загрузки. Истёкший тайм-аут с пустым чтением показывает сообщение о локали и сохраняет текст. Один и тот же код даёт все три, значит различие в том, что сообщила платформа, а не в том, чем является устройство.
Обновление списка и состояния очереди речи
Событие voiceschanged означает, что изменился список, возвращаемый getVoices(). Это не команда снова заговорить, и приложение не должно предполагать, что событие срабатывает ровно один раз. Чистая процедура обновления заменяет показанный список результатом последнего вызова, удаляет одноразовый обработчик после использования и хранит языковое предпочтение пользователя отдельно от конкретного объекта SpeechSynthesisVoice. Если доступен ручной повтор, он может вызывать ту же процедуру вместо добавления нового обработчика.
SpeechSynthesis.speak(utterance) добавляет высказывание в очередь контроллера. Повторные нажатия или вызовы обновления могут создать дублирующую речь, если интерфейс не определяет свою политику. Продукт может отключать кнопку воспроизведения, пока высказывание находится в очереди или произносится, показывать отдельную кнопку остановки либо намеренно заменять текущий запрос. Важно сделать этот переход явным. Одно лишь изменение доступных вариантов не должно добавлять запись в очередь.
Следующий код иллюстративный и не запускался. Он показывает ограниченное ожидание обновления, выбор по локали и явный запуск речи действием пользователя. Это не обещание, что каждый браузер предоставляет одинаковые голоса или принимает запрос на воспроизведение в одинаковых обстоятельствах.
Этот пример показывает только автоматическое сопоставление локали; в нём не реализованы сохранение и восстановление явного выбора голоса пользователя.
const synth = window.speechSynthesis;
const requestedLocale = 'en-GB'; // Set from the application's own locale.
let currentVoices = [];
let activeUtterance = null;
let refreshTimer = null;

function refreshVoices() {
  currentVoices = synth.getVoices();
  const exact = currentVoices.filter(voice => voice.lang.toLowerCase() === requestedLocale.toLowerCase());
  const language = requestedLocale.split('-')[0];
  const broader = currentVoices.filter(voice => voice.lang.toLowerCase().split('-')[0] === language.toLowerCase());
  return exact.length ? exact : broader;
}

function waitForVoices(onReady, timeoutMs = 1500) {
  const immediate = refreshVoices();
  if (immediate.length) {
    onReady(immediate);
    return;
  }

  const onChange = () => {
    const matches = refreshVoices();
    if (matches.length) {
      clearTimeout(refreshTimer);
      synth.removeEventListener('voiceschanged', onChange);
      onReady(matches);
    }
  };

  synth.addEventListener('voiceschanged', onChange);
  refreshTimer = setTimeout(() => {
    synth.removeEventListener('voiceschanged', onChange);
    refreshTimer = null;
    onReady(refreshVoices());
  }, timeoutMs);
}

function playFromUserAction(text) {
  const available = refreshVoices();
  const voice = available.find(item => item.default) ?? available[0];
  if (!voice) {
    showReadableRetryState();
    return;
  }

  const utterance = new SpeechSynthesisUtterance(text);
  utterance.lang = voice.lang;
  utterance.voice = voice;

  activeUtterance = utterance;
  utterance.onend = () => {
    activeUtterance = null;
  };
  utterance.onerror = () => {
    activeUtterance = null;
    showReadableRetryState();
  };
  synth.speak(utterance);
}

function stopSpeech() {
  synth.cancel();
  activeUtterance = null;
}
В производственном компоненте onReady должна обновлять селектор или видимое состояние доступности, а не сериализовать все голоса в аналитику. В примере также предполагается, что приложение реализует showReadableRetryState(). Реальный интерфейс должен не позволять обработчикам событий обновлять уже удалённый компонент, очищать оставшийся таймер при завершении и определять, что делать при втором запросе воспроизведения во время речи. Это обычные решения жизненного цикла; их нельзя вывести из метаданных голосов.
Запасной язык и активация пользователя
Выбор голоса должен следовать языковой политике приложения, а не догадке об операционной системе. Определяйте запрошенную локаль по содержимому или явной настройке приложения. Сначала ищите точное совпадение, например en-GB. Если требования продукта это допускают, используйте заранее оговорённое совпадение на уровне языка, например en-US. Если доступен только несвязанный язык, не воспроизводите его незаметно, будто он эквивалентен. Оставьте текст видимым и дайте читателю выбрать другой вариант или продолжить без озвучивания.
Значение lang описывает голос, а высказыванию тоже можно присвоить языковой тег. Ни то ни другое не переводит текст. Голос может числиться для нужной локали, но плохо произносить имя, аббревиатуру или предложение на нескольких языках. При необходимости продукт должен использовать переведённый текст и понятные языковые настройки. В статье о кодеках WebRTC также рассматривается поверхность возможностей, где заявленную доступность не следует путать с полным результатом для пользователя.
Речь должна начинаться после осознанного действия, например нажатия кнопки «Прочитать вслух». Это решение о контроле пользователя и совместимости, а не утверждение, будто спецификация Web Speech задаёт единый диалог разрешений. Политика браузера и контекст встраивания могут повлиять на запуск аудио. Интерфейс должен объяснить, как повторить попытку, если запрос не начался; ему не следует просить предоставить несуществующее разрешение API или утверждать, что нажатие гарантирует слышимый звук.
Когда пользователь меняет язык приложения, обновите запрошенную локаль и заново оцените варианты из текущего списка. Если список обновился при открытом меню, сохраняйте предпочтение, только если ему всё ещё соответствует доступный вариант. Можно явно подписать альтернативу, например: «Используется английский (США), потому что английский (Великобритания) недоступен». Прозрачную замену легче исправить, чем автоматическое переключение, скрытое за обычной кнопкой воспроизведения.
Выбор пользователя и настройки доступности должны быть независимы от аналитики. Иногда нужно локально сохранить вариант для следующего посещения, но это не оправдывает отправку всего массива голосов на сервер. Если служба передаёт текст удалённому поставщику синтеза речи, отдельно объясните этот поток данных и настройки управления им; одного localService недостаточно для полного аудита сетевой маршрутизации.
Отмена, ошибки и границы приватности
Для очереди контроллера нужна видимая модель состояний. Как минимум различайте: недоступно, загрузка, готово, в очереди или произносится, завершено, остановлено и ошибка. Кнопка остановки должна вызывать cancel() и возвращать интерфейс в предсказуемое состояние ожидания; отмена является явной остановкой, а не запросом на повтор. Подпись retryAvailable на схеме означает, что приложение может предложить новую попытку после объяснения ошибки, но для воспроизведения всё равно требуется новое действие пользователя. Поскольку отмена удаляет и ожидающие высказывания, и прерывает текущее, страница с несколькими компонентами должна учитывать, не сможет ли один компонент отменить речь, запущенную другим. Распределите владение очередью, а не позволяйте каждому виджету независимо управлять глобальным контроллером.
Назначайте обработчики завершения и ошибки каждому высказыванию. После завершения можно вернуть элемент управления воспроизведением в состояние готовности. При ошибке покажите понятное сообщение, сохраните исходный текст и предложите осмысленный повтор или альтернативу. Не вызывайте speak() автоматически снова после ошибки: повторные запросы могут накапливаться в очереди или оставить пользователя в неведении, сработала ли команда остановки. Если высказывание заменено, игнорируйте запоздавшие события от старого запроса, сравнивая его с текущим активным запросом.
Web Speech API предоставляет события, но приложению не следует обещать одну причину для всех ошибок. Причиной могут быть отсутствие голоса, доступность службы, текст, контекст браузера или другая особенность платформы. Сообщайте то, что приложению известно, например «Не удалось начать воспроизведение» или «Подходящий голос недоступен», а технические подробности оставьте для добровольной диагностики поддержки. Не выводите личность человека, установленное ПО или его местоположение из ошибки или названия голоса.
Для обычного обращения в поддержку в компактную запись можно включить продукт и версию браузера, локаль приложения, наличие подходящего голоса и категорию ошибки, показанной пользователю. Не записывайте полный упорядоченный список, каждый voiceURI, точное время каждого обновления или произнесённый текст, если только для этого нет определённой цели поддержки и согласия человека. Храните такие данные лишь в течение указанного случая. Граница приватности состоит в минимизации данных, а не в сокрытии нормального состояния приложения.
Эта статья не объясняет, как идентифицировать человека. Она описывает метаданные как потенциально контекстную поверхность браузера и сосредоточена на надёжном поведении приложения. Список браузера сам по себе не доказывает уникальную личность, а локальный иллюстративный макет не устанавливает поведение всех операционных систем, версий браузеров, языковых служб или вспомогательных технологий.
Что добавляет руководство по настройке
В руководстве по защите Speech Synthesis описаны режимы голосов из профиля и реальной системы в BotBrowser, флаги конфигурации и общая диагностика согласованности профиля. По умолчанию --bot-speech-voices=profile использует метаданные голосов из профиля; --bot-speech-voices=real использует системные голоса без этой защиты метаданных. Ни один режим не гарантирует слышимое воспроизведение. В нём нет дерева отказов пользовательского приложения для пустого начального списка, обновления voiceschanged, устаревшего выбора или очереди высказываний. Эта статья добавляет правило выбора по каждому полю, неисполнявшийся пример приложения и явные состояния интерфейса для запасного языка, воспроизведения по действию пользователя, отмены и ошибок. Эти шаги дополняют руководство по настройке; они не заявляют о воспроизведении поведения профиля и не вводят новую гарантию продукта.
При диагностике настройки разделяйте два вопроса: какие метаданные голосов возвращает API браузера и может ли хост воспроизвести слышимый звук для конкретного пользователя. Руководство по профилю или конфигурации может описывать заявленную поверхность браузера, тогда как воспроизведение зависит от самого приложения и контекста хоста. Успешное получение списка не является проверкой аудио. И наоборот, неудачный запрос воспроизведения не доказывает, что список голосов неверен.
Часто задаваемые вопросы
Означает ли пустой результат первого вызова, что синтез речи не поддерживается?
Нет. Это означает только, что текущий вызов не вернул голосов. Список может появиться позже, среда может не предоставить ни одного голоса или API может быть недоступен в этом контексте. Ограниченное время слушайте voiceschanged, предложите повтор и оставьте текст доступным. Не ждите бесконечно и не определяйте тип устройства по пустому результату.
Является ли voiceURI стабильным идентификатором для сохранения предпочтения?
Считайте его непрозрачными метаданными реализации, а не переносимым ключом учётной записи. Лучше сохранять языковое предпочтение пользователя и, при необходимости, локальный вариант отображения, который можно сопоставить с текущим списком. Если сохранённый голос больше недоступен, попросите выбрать новый, а не переключайтесь молча на другой язык.
Доказывает ли localService: true, что сетевой службы нет?
Это описывает объект голоса как локальный согласно реализации. Значение не проверяет все маршруты службы и не доказывает, что приложение целиком хранит текст на устройстве. Отдельно объясняйте фактический поток данных приложения и не превращайте этот логический флаг в широкую гарантию приватности.
Должно ли каждое событие voiceschanged запускать речь повторно?
Нет. Событие служит сигналом обновить доступные варианты, а не выражает намерение пользователя воспроизвести аудио. Обновите селектор, сохраните или сбросьте предпочтение по текущему списку и потребуйте отдельного действия для запуска речи.
Источники
- W3C Web Speech API: спецификация синтеза, объектов голосов, высказываний, методов очереди и событий.
- MDN: SpeechSynthesis: описание контроллера и его методов для браузеров.
- MDN: SpeechSynthesis.getVoices(): метод получения текущего списка голосов.
- MDN: SpeechSynthesisVoice: свойства объекта голоса.
- MDN: событие voiceschanged: событие изменения списка.
- MDN: SpeechSynthesis.speak() и cancel(): поведение очереди и отмена.
- MDN: событие ошибки SpeechSynthesisUtterance: событие ошибки высказывания.
- Защита Speech Synthesis в BotBrowser: конфигурация продукта и границы режимов профиля.
Практическое заключение
Пустой или меняющийся список голосов представляет собой состояние приложения, которым нужно управлять, а не основание идентифицировать человека или предполагать фиксированный порядок платформы. Обновляйте список по voiceschanged, выбирайте голос из актуальных метаданных согласно языковой политике приложения, начинайте речь только после явного действия пользователя и показывайте завершение, отмену и ошибки. Сохраняйте читаемый текст и собирайте только те диагностические поля, которые нужны для заявленной задачи. Следующий безопасный шаг для продуктовой команды состоит в проверке немедленных и отложенных списков, а также отказа высказывания в поддерживаемых контекстах браузеров своего приложения. При этом не утверждайте, что этот иллюстративный код или схема уже запускались.
Эта статья входит в руководство: Что такое отпечаток браузера?
Похожие статьи
Голоса синтеза речи и доступное воспроизведение в браузере
ОтпечаткиFingerprinting кодеков WebRTC: утечка медиавозможностей
ОтпечаткиИнформация об адаптере WebGPU и конфиденциальность пользователя
ОтпечаткиFingerprinting измерения текста: субпиксельное отслеживание
ОтпечаткиФингерпринтинг частоты кадров: экран и видео
ОтпечаткиЧто такое отпечаток шрифтов? Согласованность текста между платформами
Переведите BotBrowser из исследований в продакшн
Используйте эти руководства, чтобы понять модель, а затем перейти к кроссплатформенной валидации, изолированным контекстам и масштабируемому браузерному развертыванию.