Почему один странный сигнал не выносит вердикт
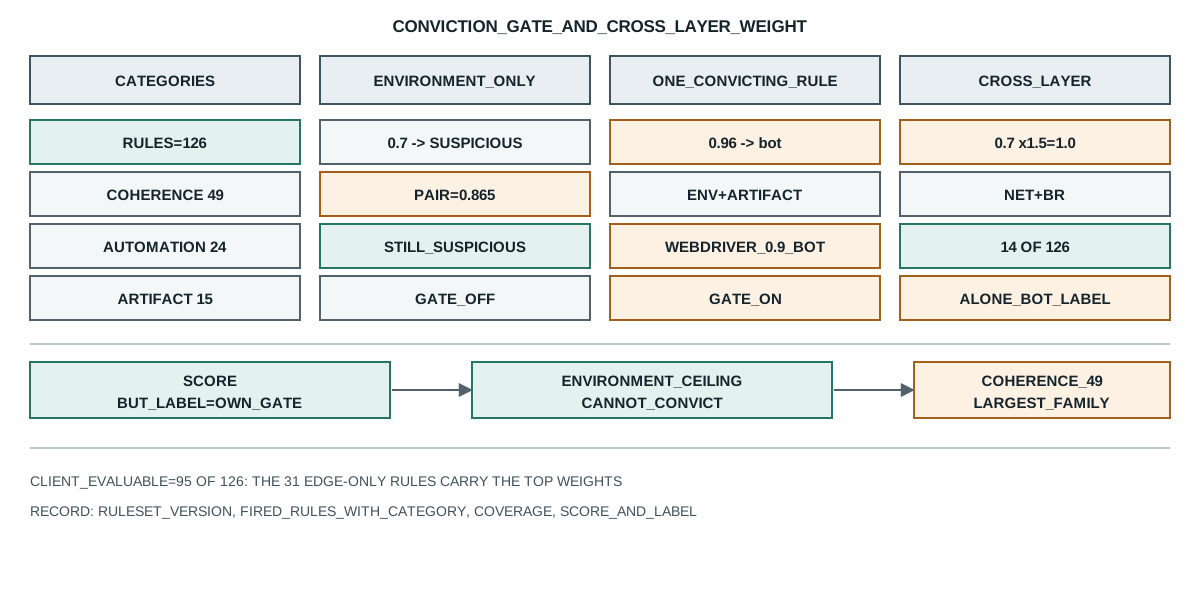
Один зонд по открытому набору правил: сигнал окружения весом 0.7 вердикт не выносит, а одно межуровневое противоречие выносит его само.
BotBrowser Team
Нужна структурированная документация по теме Отпечатки?
Эта статья относится к редакционной библиотеке. Для пошаговой настройки, справки и постоянных обновлений переходите сразу в соответствующий раздел docs.
BotBrowser позволяет воспроизвести авторизованный фикстур того же источника под объявленным профилем и сохранить ограниченную запись того, какие сигналы раскрыла страница, но он не может сделать сигнал окружения тяжелее, чем разрешает набор правил, не может превратить подтверждающий сигнал в обвиняющий и не может помешать сетевому противоречию решить вердикт до того, как страница закончит загрузку. Открытый набор правил читается здесь как данные, воспроизводит его арифметику оценки и фиксирует, какие категории могут выносить вердикт, почему сигнал весом 0.7 останавливается ниже порога, что добавляет одно правило артефакта к тем же сигналам и как одно межуровневое противоречие само пересекает линию обвинения.
Кратко
- В наборе 126 правил в семи категориях, и выносить вердикт могут только три:
coherence,automationиartifact. Остальные четыре лишь подтверждают. - Страница может задействовать 95 из 126 правил, то есть 31 правило сети и репутации в проверке на стороне браузера вообще не выполняется.
- Один сигнал окружения весом 0.7 даёт 0.7 и остаётся
suspicious, потому что правило окружения не может вынести вердикт, каким бы тяжёлым оно ни было. - Два сигнала окружения вместе дают 0.865 и всё равно остаются
suspicious, что показывает: линию держит ворота категории, а не арифметика. - Добавление одного правила артефакта к этим двум сигналам даёт 0.96 и
bot, при неизменных весах окружения. - Один сигнал автоматизации весом 0.9 выносит вердикт сам, поэтому у страницы, раскрывающей
navigator.webdriver, нет запаса вовсе. - Только 14 из 126 правил охватывают больше одного уровня, и именно их вес усиливается: 0.7 становится 1.0.
- Оценка не зависит от порядка правил, поэтому запись должна называть сработавшие правила, а не их число.
Содержание
- Какие категории могут выносить вердикт
- Почему тяжёлый сигнал окружения останавливается на полпути
- Где на самом деле проходит линия обвинения
- Сколько стоит одно межуровневое противоречие
- Запись одного показания вердикта
Какие категории могут выносить вердикт
Детектор на правилах это список утверждений о посетителе, у каждого свой вес и категория, и категория решает, что сработавшему правилу разрешено делать. В наборе, который читает зонд, 126 правил в семи категориях:
categories -> coherence=49 automation=24 artifact=15 behavioral=7 reputation=4 environment=26 prevalence=1
convicting -> coherence,automation,artifact (others corroborate only)
Три категории могут выносить вердикт, остальные четыре только добавляют к оценке. Это разделение и есть весь замысел. Правило environment описывает поверхность, которая кажется тонкой: короткий список плагинов, отсутствующий список голосов, hardwareConcurrency намного ниже возможностей машины. У многих законных посетителей эти поверхности действительно тонкие: урезанный образ рабочей станции, заблокированная корпоративная сборка, браузер без звукового устройства. Считать любую из них доказательством значит ошибочно пометить таких посетителей, поэтому набор позволяет им поднять оценку и останавливается. Библиотека детекта, называющая свои компоненты, делает то же различие: реестр детекторов и состояния компонентов BotD фиксирует, как именованный детектор сообщает наблюдённое, а не одну оценку.
Категория behavioral работает так же. Статическая страница, которую читатель просто смотрит, даёт мало ввода или не даёт его вовсе, поэтому правило об энтропии нажатий или траектории указателя не отличает читающего человека от драйвера, который ничего не внедрял. Набор помечает такие сигналы как подтверждающие по той же причине.
Правило automation иного рода. Истинный navigator.webdriver, видимое состояние Runtime.enable в CDP или маркер безголового режима в user agent описывают то, чего обычная сессия не делает. Это не тонкие поверхности, которые иногда бывают у законных посетителей, а состояния, до которых браузер доходит только под управлением драйвера. Поэтому набор может разрешить им выносить вердикт.
artifact покрывает случай, когда страница противоречит себе: нативная функция, чей исходный текст не от движка, Worker, сообщающий иные значения, чем главная страница, канвас, нарушающий собственный инвариант. Каждый из них это внутренняя несогласованность, а не тонкая поверхность, и потому он может выносить вердикт.
coherence это категория двух несогласных уровней, и она самая большая: 49 правил. TLS-рукопожатие, подразумевающее одну операционную систему, при user agent, заявляющем другую, это противоречие между тем, что говорит соединение, и тем, что говорит страница. Ни один законный посетитель такого не производит, потому что оба уровня создаёт один клиент.
Почему тяжёлый сигнал окружения останавливается на полпути
Интересно то, что ворота делают с тяжёлым правилом окружения. Зонд берёт четыре сигнала окружения и оценивает каждый по отдельности:
alone:br.webgl_not_angle -> weight=0.55 category=environment score=0.55 verdict=suspicious
alone:br.font_linux_leak -> weight=0.7 category=environment score=0.7 verdict=suspicious
alone:br.screen_zero -> weight=0.7 category=environment score=0.7 verdict=suspicious
alone:br.voices_empty -> weight=0.5 category=environment score=0.5 verdict=suspicious
Правила весом 0.7 пересекают линию подозрения на 0.35 и останавливаются на 0.7, чуть ниже линии обвинения 0.65 только потому, что ворота отказывают. Если читать только цифры, 0.7 выглядит сильной находкой; если читать вместе с категорией, это поверхность, которая может быть просто тонкой.
Это различие важно, когда команда читает отчёт со словом «подозрительно». Метка подозрения от сигнала окружения говорит, что страница выглядела необычно конкретным, названным образом. Она не говорит, что страница была автоматизирована, и отчёт, печатающий оценку без категории, приглашает именно к такому ошибочному чтению. 0.7 это не «70% пути к обвинению»; это подтверждающее наблюдение, упёршееся в потолок, который разрешает его категория.
Тот же зонд показывает, что накопление сигналов окружения этого не исправляет:
environment-pair -> weights=0.55+0.7 score=0.865 verdict=suspicious convicting=false
Два правила окружения объединяются в 0.865 по формуле noisy-or, заметно выше 0.65, и вердикт всё равно suspicious. Напечатанное convicting=false и есть причина: ни одно сработавшее правило не принадлежит обвиняющей категории, поэтому оценка может расти, а метка нет. Это намеренное решение, и именно его команды чаще всего понимают неверно, когда предполагают, что большее число означает более сильный вывод.
Практическое следствие о том, куда вкладывать усилия. Если развёртывание помечают только сигналы окружения, укреплять поверхности, которые описывают эти правила, это заведомо проигранная борьба, потому что правила созданы принимать тонкие окружения как норму. Усилия принадлежат обвиняющим категориям: держать чистыми navigator.webdriver и состояние CDP и заставить каждый realm сообщать те же значения.
Где на самом деле проходит линия обвинения
Зонд добавляет одно правило обвиняющей категории к тем же двум сигналам окружения, и вердикт переворачивается:
plus-artifact -> score=0.96 verdict=bot convicting=true categories=environment,environment,artifact
В сигналах окружения ничего не изменилось. Два правила, дававшие 0.865, дают столько же, а третье поднимает сумму до 0.96 и метку до bot, потому что convicting теперь истинно. Веса окружения никогда не были решающим фактором; им было присутствие правила обвиняющей категории.
Случаи одного сигнала говорят то же с другой стороны:
alone:br.webdriver_present -> weight=0.9 category=automation score=0.9 verdict=bot
alone:br.cdp_runtime_enabled -> weight=0.85 category=automation score=0.85 verdict=bot
alone:br.ch_he_headless -> weight=0.85 category=automation score=0.85 verdict=bot
Каждое выносит вердикт само, с весом близким к 1, но ниже. Запаса нет: страницу, раскрывающую navigator.webdriver, обвиняет один сигнал, и единственный путь назад это не раскрывать его. Такая асимметрия намеренна, потому что набор трактует состояние автоматизации как категорический факт, а не как вероятностную подсказку.
Добавление подтверждающих сигналов поверх поднимает оценку, не меняя метку:
stack -> one=0.9 two=0.955 three=0.987
Три сигнала дают 0.987, а вердикт уже был bot при одном. Отчёт, показывающий 0.99 для страницы с тремя находками и 0.9 для страницы с одной, намекает на разницу уверенности, которой набор не делает: обе обвинены, и лишние сигналы почти ничего не добавляют к решению. Оценка это сводка о том, сколько правил сработало, а метка это отдельные ворота.
Сколько стоит одно межуровневое противоречие
Последняя часть это усиление, применяемое к правилам, охватывающим несколько уровней:
cross-layer rules -> 14 of 126
amplify:net.tls_vs_ua_browser -> layers=network+browser weight=0.7 effective=1
amplify:net.h2_vs_ua_browser -> layers=network+browser weight=0.6 effective=0.9
amplify:net.datacenter_origin_proxied -> layers=network+browser+reputation weight=0.8 effective=1
Четырнадцать из 126 правил называют больше одного уровня, и вес каждого умножается на 1.5 с потолком 1. Правило 0.7 становится 1.0, а 0.6 становится 0.9. Усиление это набор, излагающий свой тезис арифметикой: противоречие между двумя независимо созданными уровнями стоит больше, чем сильное чтение одного уровня, потому что оба создаёт один клиент и ему трудно намеренно сделать их несогласными.
Межуровневое правило выносит вердикт само:
amplify-alone:net.tls_vs_ua_browser -> score=1 verdict=bot
Одно правило, оценка 1, вердикт bot. Накопление не нужно, потому что категория правила это coherence и его усиленный вес уже достигает верха шкалы. Это форма, которой команде стоит бояться больше всего: одна ошибка конфигурации, когда сетевой путь подразумевает одну операционную систему, а профиль заявляет другую, даёт обвинение из одного наблюдения.
Это объясняет и почему важна цифра покрытия на стороне браузера:
coverage -> clientEvaluable=95 of 126, edge-only=31
layer:network -> rules=28 clientEvaluable=0
layer:reputation -> rules=4 clientEvaluable=0
Каждое сетевое правило доступно только на периферии, поэтому страница, загружающая скрипт детектора в браузере, никогда не задействует межуровневые правила с самыми высокими эффективными весами. Команда, проверяющая профиль загрузкой детектора в браузере, проверила 95 правил и оставила нетронутыми 31, которые способны обвинить из одного наблюдения. Две половины отвечают на разные вопросы, и чистая проверка на стороне браузера не является доказательством о периферии. Когда значение заголовка расходится с тем, что сообщает страница, правило сравнивает два независимых источника, что client hints и предел в 500 символов описывает. Поверхность заголовков, которую читает анализатор, это одно из значений на стороне браузера, которые сравнивает правило согласованности, и client hints и предел в 500 символов фиксирует это подробно.
Последняя строка исключает одну короткую дорогу:
order-free -> forward=0.887 reverse=0.887 same=true
Те же три правила дают одну оценку в любом порядке, потому что сочетание это произведение по весам, а не последовательность. Значит отчёт не может сказать, какое правило имело значение, показывая только оценку, и единственный способ узнать это назвать сработавшие правила, их категории и уровни. Число находок это наименее информативная форма тех же данных.
Запись одного показания вердикта
Показание вердикта подтверждает узкое утверждение: эта версия набора, эти сработавшие правила дали эту оценку и эту метку. Четыре поля держат его проверяемым:
- Версия набора и её дайджест, потому что обновление может изменить вес, категорию или обвиняющий набор, и те же сигналы оценятся иначе.
- Сработавшие правила с их категорией и уровнями, потому что метка зависит от того, может ли какое-либо из них обвинить, а оценка это скрывает.
- Граница покрытия, потому что проверка на стороне браузера никогда не видит периферийные правила с самыми высокими эффективными весами.
- Оценка и метка вместе, потому что 0.99 с подтверждающими сигналами и 0.9 с одним обвиняющим это один вердикт, а отчёт, печатающий только оценку, намекает на уверенность, которой ворота не давали.
Публичные источники
- MDN: Navigator.webdriver
- MDN: WebGLRenderingContext.getParameter()
- RFC 8446: TLS 1.3
- RFC 9113: HTTP/2
- BotBrowser: справочник согласованности автоматизации
Практический вывод
Читайте вердикт детектора по правилу и категории, а не по оценке: 0.7 от правила окружения и 0.7 от правила автоматизации это одно число и совершенно разные находки. Воспринимайте метку подозрения, построенную только на сигналах окружения, как описание тонкой поверхности, и направляйте укрепление на обвиняющие категории, где одна утечка решает вердикт. Помните, что проверка на стороне браузера покрывает правила, которые страница может оценить, и оставляет межуровневые правила, чей вес усилен до верха шкалы, полностью вне поля зрения, поэтому чистый результат внутри страницы ничего не говорит о соединении, которым пользовался клиент. Механика оценки в этом разборе читается вместе с построчным разбором сигналов в подменённые нативные функции и что видит список toString, а согласованность между realm, которая не даёт сработать правилу coherence, разобрана в целостность API между realm.
Эта статья входит в руководство: Что такое отпечаток браузера?
Похожие статьи
BotD: какие детекторы действительно выполняются
Отпечаткиua-parser-js: Client Hints, боты и предел 500
ОтпечаткиЧто такое отпечаток шрифтов? Согласованность текста между платформами
ОтпечаткиКомбинаторы Promise: первый отказ и вечное ожидание
ОтпечаткиDevice Memory API и производительность веба: подсказка памяти
ОтпечаткиЧто такое отпечаток браузера?
Переведите BotBrowser из исследований в продакшн
Используйте эти руководства, чтобы понять модель, а затем перейти к кроссплатформенной валидации, изолированным контекстам и масштабируемому браузерному развертыванию.