navigator.cpuPerformance : niveaux et vie privée
Lire navigator.cpuPerformance, distinguer absence et zéro, puis comprendre Chrome 152, les remplacements et les limites des niveaux CPU.
BotBrowser Team
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
navigator.cpuPerformance est une classification grossière des performances CPU, pas un nom de processeur, une mesure de son utilisation actuelle ou une vérification d'identité. Chrome 152 présente cette API parmi ses fonctionnalités publiées. Le brouillon WICG fixé définit quatre niveaux positifs et une valeur inconnue distincte, 0 ; une propriété absente constitue une autre observation. BotBrowser peut configurer sa surface documentée de nombre de cœurs, mais un réglage --bot-cores seul ne peut pas établir le résultat de cette autre propriété. Cette limite importe lorsqu'un rapport juxtapose niveau CPU, nombre de cœurs, mémoire et signaux temporels.
Regarder la vidéo
Cette vidéo, en anglais, suit la même question que l’article : le niveau renvoyé par navigator.cpuPerformance est une classification statique et grossière, pas une mesure de charge en direct. Elle distingue l’absence de la propriété, le zéro numérique qui signifie inconnu, un niveau positif courant, un niveau futur non reconnu et une lecture en échec ; puis elle montre la correspondance par nombre de cœurs du brouillon, l’ajustement de modèle défini par l’implémentation, la bande de conception de la vie privée, les remplacements documentés de Chrome et une lecture enregistrée sous Ubuntu Chrome depuis un fixture contrôlé. Elle ne reconstruit ni le nombre exact de cœurs, ni le modèle du processeur, ni un score de référence. L’audio est en anglais.
Résumé
- Distinguer l'absence de
navigator.cpuPerformance, la valeur numérique0et un niveau déclaré. Une information manquante ne classe pas un appareil comme peu performant. - Le calcul initial du brouillon emploie les cœurs déclarés par le système, avec des ajustements par modèle CPU définis par l'implémentation. Un niveau ne reconstitue ni un nombre exact de cœurs ni un modèle précis.
- Un niveau statique ne suit pas la charge actuelle. Les remplacements par utilisateurs et administrateurs documentés par Chrome empêchent aussi de traiter chaque valeur comme une mesure matérielle non modifiée.
- L'exposition spécifiée concerne un contexte
Windowsécurisé. La documentation de Chrome 152 n'établit pas sa disponibilité dans chaque navigateur, environnement intégré ou Worker. - Des catégories larges réduisent le détail, pas l'existence d'un signal matériel. Un dossier de support CPU n'a pas besoin d'identifiants sans rapport avec sa question.
Sommaire
États de retour avant les conclusions matérielles
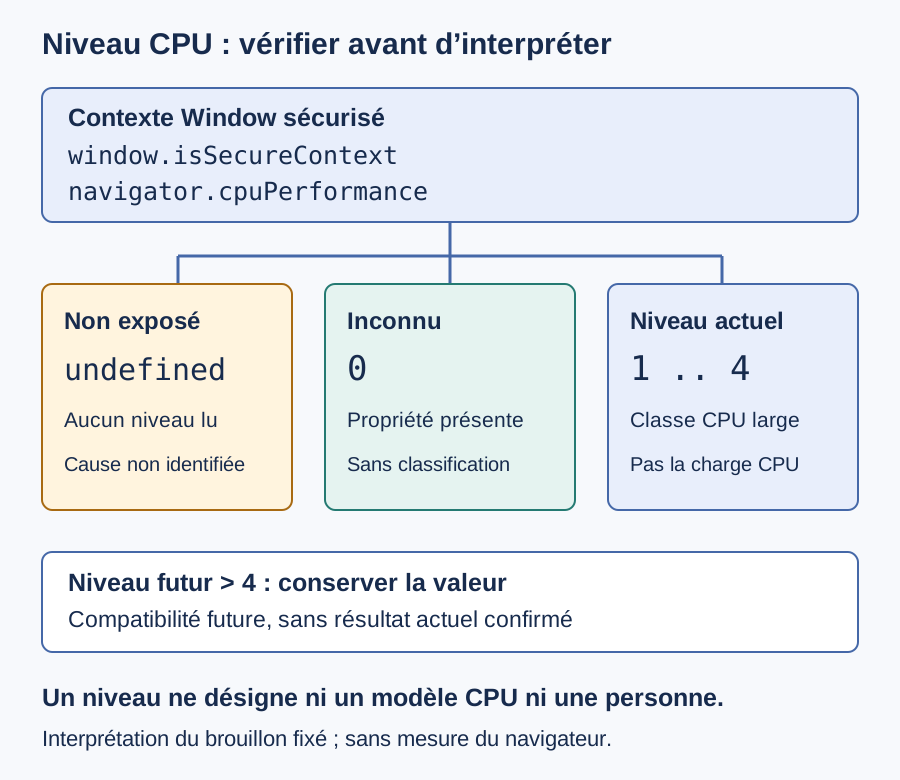
Le brouillon fixé de CPU Performance API ajoute à Navigator une propriété en lecture seule de type unsigned short. Son IDL déclare SecureContext et Exposed=Window. Ces détails décrivent le contexte de l'interface ; ils ne constituent pas une matrice de compatibilité de tous les navigateurs installés. Le contexte d'observation doit être établi avant d'attribuer un sens au résultat.
| Observation | Sens étayé par la source ou le collecteur | Conclusion non établie |
|---|---|---|
Contexte refusé par isSecureContext | La fonction n'a pas poursuivi la collecte dans ce contexte | L'appareil appartient à un niveau faible |
| Propriété non exposée | Elle est absente du Navigator inspecté | La cause, un produit de confidentialité ou un modèle CPU |
Valeur numérique 0 | L'API indique une classification inconnue | Zéro cœur, absence de CPU ou échec d'une lecture JavaScript |
Entier de 1 à 4 | Un niveau positif actuel | Débit exact, identité matérielle ou utilisation présente |
Entier positif supérieur à 4 | Un futur niveau inconnu de ce consommateur | Une valeur effectivement renvoyée par le getter fixé |
| Erreur de lecture ou type inattendu | La collecte n'a pas produit la forme attendue | Une classification matérielle valide |
La différence entre exposition et classification demeure même lorsqu'un tableau de bord préfère une étiquette compacte. Remplacer à la fois undefined et 0 par « inconnu » supprime une information sur l'interface disponible. Les remplacer par le niveau 1 est plus grave : cela invente un jugement de performance que le navigateur n'a pas fourni. La comparaison peut ainsi devenir trompeuse avant toute déduction matérielle.
Une fonction côté Window peut conserver cette différence sans requête réseau ni test de performance. Les branches suivantes illustrent une politique de collecte, pas la transcription d'une exécution dans un navigateur. La vérification du contexte sécurisé est volontairement préalable : s'arrêter à cet endroit signifie que la collecte a été omise, pas qu'une indisponibilité de l'API a été diagnostiquée de façon certaine.
function readCpuTier() {
  if (!globalThis.isSecureContext) return { state: 'context-skipped' };
  if (!('cpuPerformance' in navigator)) return { state: 'not-exposed' };
  try {
    const tier = navigator.cpuPerformance;
    if (!Number.isInteger(tier) || tier < 0 || tier > 65535) {
      return { state: 'unexpected-value' };
    }
    if (tier === 0) return { state: 'unknown' };
    if (tier <= 4) return { state: 'tier', tier };
    return { state: 'future-tier', tier };
  } catch {
    return { state: 'read-error' };
  }
}
Le brouillon impose actuellement au getter la plage de 0 à 4, mais demande aux applications de tolérer des niveaux supplémentaires dans de futures révisions. Préserver un entier positif inconnu assure une compatibilité future ; cela ne prétend pas qu'une implémentation actuelle produit le niveau 5. Une application peut adopter un réglage prudent dans cet état, mais son diagnostic ne devrait pas le transformer silencieusement en catégorie déjà connue.
La présence d'une propriété a par ailleurs une portée moindre qu'une vérification d'authenticité. Trouver cpuPerformance dans l'objet navigator d'une page ne garantit pas la fiabilité de l'environnement JavaScript, et une lecture réussie n'authentifie pas l'appareil. Cette présence sert à gérer une capacité. Elle ne doit devenir ni une condition d'accès à un compte ni l'affirmation qu'un rapport a prouvé qui utilise la machine.
Classification du brouillon et limites
Le brouillon commence par un nombre de cœurs fourni par le système d'exploitation. Un cœur y désigne une unité d'exécution physique ou logique selon ce que déclare le système. Cette entrée n'est pas définie comme le nombre renvoyé au JavaScript de la page par navigator.hardwareConcurrency. L'analyse du nombre de cœurs déclaré distingue ce signal visible du parallélisme sous-jacent. Utiliser la valeur de la page dans la table ne reproduit pas la classification du navigateur à partir des données système.
| Entrée système initiale dans le brouillon | Niveau initial |
|---|---|
Nombre de cœurs indisponible, ou 0 | 0 |
1 cœur | 1 |
De 2 à 4 cœurs | 2 |
De 5 à 10 cœurs | 3 |
Plus de 10 cœurs | 4 |
La même section autorise des ajustements lorsqu'un modèle CPU connu est nettement plus ou moins performant que les appareils typiques de même nombre de cœurs. Ces ajustements déplacent généralement la classification d'au plus un niveau, exigent des informations système fiables sur le modèle et concernent un ensemble de modèles défini par l'implémentation. « Généralement » est une réserve de la source, pas la promesse que toutes les implémentations emploient une liste identique.
La correspondance inverse est donc indéterminée. Le niveau 3 peut provenir du groupe de 5 à 10 cœurs, mais les ajustements de modèle peuvent aussi modifier la classification. Avant même ces ajustements, un groupe comprenant plusieurs valeurs ne révèle pas un nombre exact de cœurs. Après eux, déduire un processeur unique de l'entier final est encore moins fondé. La catégorie renvoyée contient moins d'information que les entrées internes qui ont contribué à la choisir.
L'implémentation de référence et la démonstration liées par WICG sont explicitement non normatives. Leur résultat aide à comprendre l'algorithme, sans prouver qu'un navigateur installé utilise les mêmes données de modèles. Reconstituer un résultat de référence avec une entrée hypothétique n'est pas non plus une observation mesurée du navigateur. Révisions des sources, choix d'implémentation livrés et valeurs réellement renvoyées sont des catégories de preuve distinctes.
Le brouillon demande que les ajustements reflètent des performances mesurées dans des conditions idéales avec des tests pertinents. Cette consigne de classification ne transforme pas l'entier d'une page en score de benchmark. Un niveau n'a pas d'unité publiée en secondes, opérations par seconde ou pourcentage d'utilisation. Diviser deux niveaux ne donne pas un rapport de vitesse significatif : le niveau 4 ne doit pas être présenté comme deux fois plus rapide que le niveau 2.
De même, l'exemple de visioconférence associe des niveaux à des préréglages de résolution et d'effets, mais décrit cette interprétation comme propre à l'application. Une autre charge peut dépendre du GPU, de la pression mémoire, de la latence réseau ou d'un chemin d'instructions particulier. Choisir un préréglage initial modéré peut être raisonnable ; garantir une vidéo fluide, une inférence de modèle ou une cadence fixe à partir du niveau dépasse ce qu'établit la valeur.
Niveaux statiques, pression dynamique et temps
La reproductibilité est une règle de conception déclarée : le même appareil devrait renvoyer le même niveau plutôt que changer avec sa charge ou son utilisation actuelle. Le brouillon distingue aussi la correction d'erreurs de classification d'une redéfinition des anciens niveaux à chaque nouvelle génération de machines. Cette distinction préserve le sens de l'échelle tout en permettant de corriger des erreurs. Statique ne signifie pas identique à jamais dans toutes les versions et configurations administratives.
| Surface | Question traitée | Substitution invalide |
|---|---|---|
navigator.cpuPerformance | Quelle catégorie statique grossière est déclarée ? | Un indicateur de charge CPU en direct |
navigator.hardwareConcurrency | Combien de processeurs logiques sont exposés à la page ? | L'entrée système exacte du niveau ou l'identité du modèle |
navigator.deviceMemory | Quelle catégorie approximative de mémoire est déclarée ? | Une classification CPU |
| Compute Pressure | Quelle information dynamique de pression cette API expose-t-elle ? | Un niveau matériel stable |
performance.now() | Quels horodatages sont disponibles pour une mesure ? | Une lecture directe d'une catégorie de performance CPU |
La différence avec la pression dynamique change le diagnostic. Un onglet peut ralentir alors que son niveau CPU ne bouge pas. Cette combinaison n'est pas automatiquement contradictoire : une catégorie statique et une charge variable décrivent des choses différentes. L'analyse des charges avec Compute Pressure traite le retour dynamique et les limites de cette API ; elle concerne l'adaptation à la pression, plutôt que l'interprétation d'une catégorie.
Les temps nécessitent une autre séparation. Chronométrer une tâche mesure un chemin d'exécution précis dans des conditions données. Le résultat comprend des effets que le niveau n'est pas conçu pour rapporter continuellement. L'analyse de confidentialité des mesures temporelles distingue la précision des horodatages et les observations de durée des étiquettes matérielles. Une durée courte ne peut pas être insérée dans la table des niveaux comme si ces deux surfaces partageaient une échelle.
Une application peut activer un effet visuel optionnel coûteux à partir du niveau, puis manquer de réactivité. La première question est de savoir quelle décision a utilisé ce niveau : préréglage initial, autorisation permanente ou réglage recalculé périodiquement. Si seul le préréglage initial en dépend, la lenteur ne démontre pas à elle seule une mauvaise classification. La charge peut demander un mécanisme d'adaptation distinct, capable de réduire l'effet sans réécrire l'enregistrement matériel.
Relire la propriété en boucle ne remplace pas l'observation de la charge pertinente. L'indépendance vis-à-vis de l'utilisation signifie qu'une boucle de lecture n'est pas censée révéler la saturation actuelle. Stocker le même entier chaque seconde ajoute de l'activité et du stockage sans expliquer si une image, un calcul ou une requête manque son échéance. La question mesurée doit venir de la panne applicative, pas de la commodité d'un champ navigator disponible.
Vie privée et dossiers minimaux de comparaison
La section de confidentialité WICG décrit la divulgation volontairement limitée d'un petit entier. Elle vise beaucoup d'appareils et de modèles par niveau, avec l'intention explicite d'inclure au moins 10% des modèles existants et 10% des appareils par catégorie. Il s'agit d'objectifs de conception, pas de mesures de population livrées avec chaque réponse. La propriété ne contient ni le dénominateur ni un audit prouvant qu'un déploiement respecte actuellement ces objectifs.
Cette distinction compte pour l'interprétation d'empreintes. Une catégorie grossière reste observable, et la conception recherche sa reproductibilité sur le même appareil. Un rapport peut la juxtaposer à la plateforme, à la mémoire et à d'autres observations matérielles. Leur combinaison peut modifier ce que sait un collecteur, mais le petit espace de sortie ne détermine pas la singularité réelle de cette combinaison dans une population. Aucun pourcentage d'unicité ne découle de la simple liste des niveaux possibles.
Une propriété absente peut aussi signaler une limite d'observation plutôt qu'une protection volontaire. L'exposition au contexte Window sécurisé, l'implémentation du produit et le contexte inspecté sont pertinents. Attribuer le champ manquant à un outil de confidentialité nommé sans preuve ajoute une nouvelle déduction non étayée. Le résultat de support le plus sûr conserve l'état effectivement recueilli et le contexte nécessaire à la reproduction de ce problème précis.
| Champ du dossier de support | Rôle | Limite de collecte |
|---|---|---|
| Produit et version du navigateur pertinents | Relier le résultat à une disponibilité documentée | Ne pas remplacer une version suffisante par un relevé complet d'en-têtes identifiants |
| Contexte Window et décision de contexte sécurisé | Expliquer où la collecte continue ou s'arrête | Un contexte refusé ne prouve pas une absence matérielle |
| État du collecteur et niveau si présent | Préserver la forme réelle du résultat | Ne pas convertir 0 ou une absence en niveau 1 |
| Remplacement utilisateur ou entreprise vérifié | Expliquer une différence de configuration connue | Conserver l'inconnu si rien n'a été vérifié |
| Date et révision de source pertinentes | Séparer le cas actuel d'une documentation ancienne | Ne pas ajouter d'historique ou d'identifiant de compte sans rapport |
Une comparaison utile n'a pas à devenir un export général d'empreinte. Pour une exposition de niveau inattendue, l'état et la version peuvent suffire à déterminer la prochaine question de compatibilité. Sorties Canvas brutes, chaînes du moteur WebGL, polices installées et identifiants intersites n'aident pas automatiquement. Les ajouter parce qu'un autre rapport les affiche étend la collecte sans en démontrer le besoin.
La conservation doit suivre la tâche de support. Expliquer la disponibilité d'une fonction n'exige pas une clé d'identité permanente reliant les visites futures. Si le navigateur change de version ou si l'application adopte une autre révision de la spécification, une comparaison datée peut documenter directement ce changement. Réutiliser un ancien niveau comme étiquette immuable masque les différences de source et de configuration que le diagnostic doit conserver.
Séparer configuration déclarée et observation évite aussi des comparaisons trompeuses de produits. Un réglage connu renseigne la configuration ; la lecture renseigne l'état visible dans la page. Aucun ne devrait remplacer silencieusement l'autre. Si la valeur diffère d'un préréglage ou d'une heuristique de référence, conserver les deux faits et leurs sources est préférable à inventer une conclusion sur le matériel ou l'intention d'une personne.
Prise en charge Chrome et limites de contrôle BotBrowser
Les notes de Chrome 152 mentionnent CPU Performance API et indiquent que les utilisateurs et administrateurs peuvent remplacer le niveau déclaré via les réglages Chrome et les politiques d'entreprise. C'est une affirmation propre à Chrome. L'algorithme du brouillon WICG ne documente pas, à lui seul, les mêmes réglages dans chaque autre navigateur ou application intégrée.
Un niveau déclaré ne représente donc pas toujours une classification système intacte. Un remplacement Chrome connu constitue une autre entrée concrète du résultat visible. Si son état n'est pas accessible au diagnostic, la conclusion appropriée est qu'il n'a pas été vérifié. L'impossibilité d'inspecter la politique de l'administrateur depuis une page ne justifie pas de supposer l'absence de remplacement.
Les preuves de version ont une limite comparable. Une fonctionnalité figurant dans les notes de Chrome 152 documente cette version, pas nécessairement la configuration du navigateur intégré d'une application mobile. Une chaîne de version Chromium n'établit pas à elle seule les choix du produit environnant. La détection dans le contexte réel doit accompagner la lecture de la documentation, plutôt qu'être remplacée par une hypothèse de marque ou de version.
Les comparaisons avec des Workers exigent une attention particulière : l'IDL fixé expose la propriété à Window et étend Navigator, pas WorkerNavigator. Lire la valeur dans la fenêtre principale puis l'envoyer à un Worker y crée une valeur fournie par l'application ; cela ne démontre pas une propriété native du Worker. Le dossier doit préciser le contexte de lecture initial plutôt que déduire une parité entre contextes d'un message relayé.
La référence BotBrowser sur les cœurs CPU documente navigator.hardwareConcurrency, les choix --bot-cores et les limites d'affinité des Workers. Linux et Windows disposent d'une affinité documentée ; macOS conserve le nombre déclaré configuré sans ce mécanisme. Ces indications concernent une surface et une contrainte d'exécution précises. Elles ne documentent pas une réécriture de navigator.cpuPerformance par le profil ou l'option de nombre de cœurs.
La référence de stockage et de mémoire décrit d'autres surfaces mémoire. Une catégorie mémoire ne définit pas un niveau CPU, et un réglage de stockage ou de tas ne prouve pas non plus le contrôle de cette propriété. La documentation doit nommer une surface avant qu'une comparaison attribue son contrôle à un réglage. Une observation directe peut ensuite étayer le résultat limité à son environnement enregistré, pas une protection universelle.
Questions fréquentes
Un niveau inconnu doit-il désactiver toutes les fonctions optionnelles ?
Une application peut choisir un préréglage prudent pour 0, mais l'exemple WICG illustre un autre choix propre à une application. Aucune configuration unique n'est imposée par la valeur inconnue. Séparer l'observation de la politique et permettre de réduire une fonction coûteuse en cas de mauvaise réactivité préserve cette distinction. La politique peut évoluer sans prétendre que la propriété initiale fournissait une classification plus précise.
Un niveau peut-il servir d'identifiant d'autorisation ?
L'API renvoie une petite catégorie de performance, pas une déclaration d'autorisation signée. Chrome documente aussi des remplacements utilisateur et administrateur. Autoriser une opération demande des preuves adaptées ; une catégorie matérielle ne les apporte pas. L'employer comme identifiant de connexion lui attribuerait un sens de confiance que ni son type ni la documentation citée ne définissent.
Que se passe-t-il si une spécification ultérieure ajoute un niveau ?
Préserver l'entier positif en le distinguant d'une valeur familière de 1 à 4, puis choisir délibérément une solution de repli applicative. Le brouillon prévoit des niveaux supérieurs alors que son getter actuel impose la plage existante. Un consommateur compatible avec l'avenir ne devrait pas transformer une catégorie inconnue en erreur de collecte seulement parce que ses étiquettes n'ont pas encore été actualisées.
Un niveau stable dispense-t-il de dater une comparaison ?
Une observation appartient toujours à une version, une configuration produit et une révision de source. Le brouillon permet de corriger des classifications et Chrome documente des remplacements. Date et version expliquent pourquoi deux dossiers reposaient sur des hypothèses différentes. Ce sont des informations de provenance pour le support, pas les éléments d'un enregistrement d'identité durable.
Sources
- Brouillon fixé de WICG CPU Performance API
- Questionnaire fixé de sécurité et confidentialité WICG
- Notes Chrome 152 sur CPU Performance API
- Référence BotBrowser sur les cœurs CPU
- Référence BotBrowser sur les quotas et la mémoire
Conclusion pratique
Enregistrer l'état d'exposition avant d'interpréter navigator.cpuPerformance. Employer un niveau positif comme point de départ grossier, distinguer 0 d'une propriété absente et préserver les valeurs futures sans inventer leur sens. La compatibilité dépend du produit et du contexte Window réels. Un réglage de cœurs, une heuristique de référence ou un niveau peu détaillé ne suffisent pas à prouver une identité CPU, le contrôle de cette surface par un produit ou le résultat d'une décision d'un autre service.
Cet article fait partie du guide : Qu'est-ce qu'une empreinte de navigateur ?
Articles Connexes
Comment hardwareConcurrency révèle les cœurs réels de votre CPU
EmpreinteEmpreinte getClientRects : cohérence DOMRect
EmpreinteDétection Android WebView avec CreepJS : limites
EmpreinteMoteur de rendu WebGL absent : vie privée ou contexte ?
EmpreinteTemps performance.now et empreinte du navigateur
EmpreinteSignaux Math de CreepJS : lire les champs
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.