Prédiction CreepJS : agrégation et états inconnus
Comparez la recherche getPrediction de CreepJS à l’agrégation de signaux dans renderPrediction et aux états unknown ; aucune ne prouve une identité d’appareil.
BotBrowser Team
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
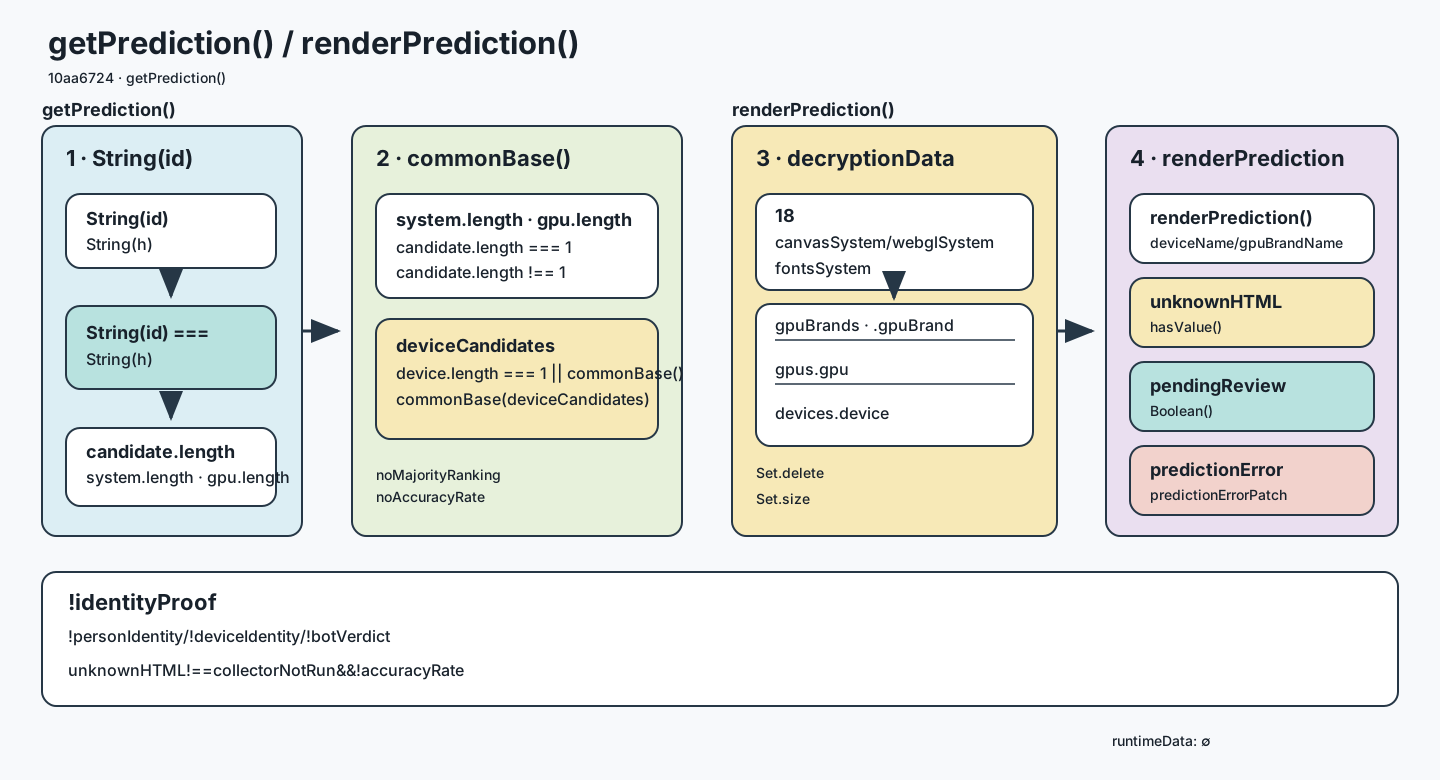
BotBrowser peut maintenir la cohérence d’un profil déclaré entre les surfaces visibles par le navigateur, mais ne peut pas certifier une prédiction collective fournie par un tiers. Dans le code figé de CreepJS, getPrediction() recherche une ligne de données collectives et choisit des candidats, tandis que renderPrediction() lit séparément decryptionData, agrège des champs de signaux et affiche des états de révision ou de score. Ce sont deux chemins distincts ; aucun de leurs résultats ne prouve l’identité d’une personne ou d’une machine, ni un verdict de bot.
TL;DR
getPredictionrecherche dans les données fournies une ligne dont l’idcorrespond au hash demandé, y compris après conversion des deux valeurs en chaînes. La variable locale nomméedecryptedest la clé de l’objet correspondant ; cette fonction ne déchiffre pas la ligne.- Les champs système, GPU et marque de GPU ne sont renvoyés que si leurs listes de candidats contiennent exactement une valeur. Un appareil peut aussi être renvoyé si plusieurs noms partagent une même base.
- Le rendu réduit les valeurs de 18 enregistrements de collecteurs nommés à trois objets JavaScript
Setpour la marque de GPU, le GPU et l’appareil.Setsupprime les doublons, puis le code retireundefined; cette agrégation ne conserve pas quel collecteur a fourni chaque valeur restante. unknownHTML,pendingReview, les notes de mélange collectif, les marqueurs de prédiction et le marqueur d’erreur sont des branches distinctes. Aucune ne représente une probabilité calibrée que l’étiquette soit correcte.
Contents
- Une étiquette de prédiction est une sortie agrégée
- Faire correspondre la ligne collective avant de lire ses champs
- Le nombre de candidats détermine les valeurs renvoyées
- Dix-huit enregistrements alimentent trois ensembles dédupliqués
- Séparer le choix de l’appareil des états de score
- Conserver un relevé de comparaison lié à la source
- Practical conclusion
Une étiquette de prédiction est une sortie agrégée
Le mot « prédiction » peut susciter une interprétation plus forte que ce que permet l’implémentation. En voyant un nom d’appareil à côté d’un score, un lecteur peut supposer que la page a identifié un appareil physique ou mesuré la probabilité que le nom soit correct. L’implémentation figée de CreepJS ne justifie aucune de ces conclusions. Elle montre comment certaines valeurs sont sélectionnées et affichées à partir de ses entrées ; la source ne fournit ni étude de calibration, ni intervalle de confiance, ni identifiant individuel.
Deux fonctions répondent à des questions différentes. getPrediction recherche une ligne de données collectives et réduit quatre listes de candidats aux champs system, device, gpu et gpuBrand. renderPrediction reçoit des objets de collecteurs, combine certains champs entre eux, puis construit le balisage de la zone de prédiction et des lignes de signaux individuelles. Le résultat de la recherche et le résumé rendu des collecteurs ne doivent pas être confondus avec un score opaque unique.
Le guide CreepJS sur les groupes de signaux et les mensonges explique les étiquettes par surface, tandis que l’analyse des vérifications croisées suit les motifs ordonnés derrière botHash. Ces sujets ne tracent ni la correspondance de la ligne collective ni les branches de candidats et d’affichage du panneau de prédiction.
Cette distinction compte lorsqu’un rapport change. Une étiquette peut disparaître parce qu’une liste de candidats contient désormais deux valeurs, parce que les valeurs des collecteurs ne partagent plus une base, parce qu’un champ n’a pas été fourni ou parce que la prédiction a emprunté sa branche d’erreur. Ces chemins n’ont pas le même sens. L’absence d’une valeur unique ne prouve pas que le navigateur n’a pas de GPU ; un marqueur d’erreur ne prouve pas que tous les collecteurs ont été exécutés puis se sont contredits.
Le périmètre est la révision figée 10aa6724cd33a1015db1574211890518cd04f0cc du fichier CreepJS src/prediction/index.ts, et non une observation actuelle du service CreepJS en ligne. Le contenu général de /docs/proof/fingerprinting-privacy-threat/ décrit les signaux d’empreinte du navigateur, mais ne cartographie pas les branches de ce module de prédiction.
Faire correspondre la ligne collective avant de lire ses champs
getPrediction reçoit hash et data. La fonction parcourt les clés de data, cherche dans le tableau placé sous chaque clé et compare l’id de chaque élément au hash demandé. La comparaison accepte l’égalité directe ou l’égalité après conversion des deux valeurs en chaînes. La clé contenant l’élément correspondant est stockée dans une variable locale nommée decrypted.
Ce nom de variable ne prouve pas l’existence d’une opération cryptographique. Dans cette fonction, l’opération pertinente est une recherche dans un tableau et une comparaison d’identifiants. La source ne déchiffre pas l’élément ici. La description précise est « recherche de ligne collective par hash », pas « déchiffrement de la prédiction ». Le nom local d’une variable ne change pas l’opération effectuée par le code.
Lorsqu’un élément correspondant est trouvé, la fonction copie quatre tableaux dans des variables locales : devices, systems, gpus et gpuBrands. Si un tableau manque, un tableau vide est utilisé. L’objet résultat sélectionne ensuite une valeur publique dans chaque liste. La recherche peut donc réussir alors qu’un ou plusieurs champs renvoyés restent undefined : trouver une ligne et obtenir une valeur sans ambiguïté sont deux étapes distinctes.
| Valeur source | Action de recherche | Interprétation prudente |
|---|---|---|
item.id | Comparaison au hash fourni, avec égalité après conversion en chaîne | Un enregistrement correspondant existe dans l’objet de données fourni. |
item.systems | Liste vide si le champ manque ; renvoi d’un système pour un seul candidat | Zéro ou plusieurs candidats ne produisent pas de valeur system unique. |
item.gpus | Liste vide si le champ manque ; renvoi d’un GPU pour un seul candidat | L’absence d’une étiquette GPU renvoyée ne signifie pas que le navigateur n’a pas de GPU. |
item.gpuBrands | Liste vide si le champ manque ; renvoi d’une marque pour un seul candidat | La fonction ne classe pas plusieurs marques et ne donne pas un niveau de confiance pour l’une d’elles. |
item.devices | Liste vide si le champ manque ; renvoi d’un candidat ou d’une base commune | Un préfixe textuel partagé est une règle de sélection, pas une vérification indépendante du matériel. |
La dernière ligne est particulièrement facile à surinterpréter. Le commentaire du code donne Android 10 comme base commune à Android 10 et Android 10 Blah Blah. Cet exemple documente une règle d’inclusion de chaînes. Il ne montre pas que CreepJS a confirmé la version exacte du système d’exploitation d’un navigateur en ligne.
Le nombre de candidats détermine les valeurs renvoyées
Les règles de retour sont volontairement asymétriques. Trois champs exigent un seul candidat, tandis que device dispose d’une solution de repli fondée sur une base commune. La longueur du tableau explique pourquoi un champ peut être absent alors que la ligne collective existe.
| Champ | Condition de candidat dans le code figé | Valeur renvoyée si la condition échoue |
|---|---|---|
system | systems.length == 1 | undefined |
gpu | gpus.length == 1 | undefined |
gpuBrand | gpuBrands.length == 1 | undefined |
device | Un appareil, ou un nom de base inclus dans chaque chaîne candidate | L’assistant de base commune renvoie undefined si aucun nom n’est partagé par tous. |
Pour les systèmes, modèles de GPU et marques de GPU, l’implémentation ne choisit pas le candidat le plus fréquent et ne classe pas les candidats selon un score. Elle vérifie si le tableau contient un élément. Si ce n’est pas le cas, le champ vaut undefined. C’est une limite explicite à l’ambiguïté, pas un classement caché.
Pour les appareils, getBaseDeviceName cherche une chaîne candidate a telle que chaque chaîne candidate b contienne a. S’il n’y a qu’un candidat, le code le renvoie directement avant d’utiliser l’assistant. S’il y en a plusieurs, une base commune peut être renvoyée ; si aucun nom n’apparaît dans tous les candidats, cette branche ne produit pas un nom unique. La règle est textuelle et ne doit pas être décrite comme un calcul de distance matérielle.
Ces exemples dérivés de la source montrent le chemin de code, pas un rapport en ligne :
| Liste de candidats | Résultat du chemin de code | Ce que le résultat ne prouve pas |
|---|---|---|
systems contient une entrée | Cette entrée est renvoyée comme system | Que l’étiquette identifie le système d’exploitation d’une personne. |
gpus contient deux entrées | Aucune valeur unique gpu n’est renvoyée | Que les deux GPU étaient absents de tous les collecteurs. |
devices contient Android 10 et Android 10 Blah Blah | La base commune Android 10 peut être renvoyée | Qu’une version particulière d’Android a été vérifiée indépendamment. |
devices contient des noms sans lien et aucune base présente partout | L’assistant de base ne renvoie pas de valeur | Que le navigateur est invalide ou automatisé. |
Une valeur undefined est un état utile à conserver. La remplacer par le premier candidat, une majorité supposée ou un appareil déduit inventerait une règle de sélection absente de cette fonction. Une feuille de comparaison devrait enregistrer « aucune valeur unique renvoyée » séparément de « champ source absent ».
Dix-huit enregistrements alimentent trois ensembles dédupliqués
Les champs agrégés gpuSystem et gpuModelSystem ne décrivent ni la création de contextes WebGL ni la prise en charge des extensions ; l’analyse du rapport WebGL de CreepJS examine séparément les signaux de contexte et de capacité du moteur de rendu.
renderPrediction lit des objets de signaux nommés et construit trois instances de Set. Chaque ensemble reçoit une propriété issue de 18 enregistrements : jsRuntime, emojiSystem, domRectSystem, svgSystem, mimeTypesSystem, audioSystem, canvasSystem, canvasPaintSystem, canvasTextSystem, canvasEmojiSystem, textMetricsSystem, webglSystem, gpuSystem, gpuModelSystem, fontsSystem, voicesSystem, screenSystem et deviceOfTimezone.
Les propriétés sont projetées séparément. Un ensemble recueille gpuBrand, un autre gpu, et un troisième device. Chaque enregistrement est protégé par une solution de repli sur un objet vide avant la lecture de sa propriété. Après construction, le code retire undefined de chaque ensemble. Les valeurs égales se réduisent à une seule entrée parce que Set conserve les valeurs uniques.
| Ensemble agrégé | Propriété lue dans chacun des 18 enregistrements | Transformation directe visible dans la source |
|---|---|---|
gpuBrands | .gpuBrand | Construire un ensemble, puis retirer undefined. |
gpus | .gpu | Construire un ensemble, puis retirer undefined. |
devices | .device | Construire un ensemble, puis retirer undefined. |
Cette opération réduit une collection de champs nommés à des valeurs uniques, mais l’ensemble résultant n’indique pas quel collecteur a fourni chaque valeur restante. Si cinq collecteurs fournissent le même gpuBrand, l’ensemble contient une valeur, pas un compte de cinq. Si deux collecteurs divergent, l’ensemble peut contenir deux valeurs, mais l’écran n’indique toujours pas quelle API a produit chacune. Le module amont montre la liste de sources dans le code ; si la provenance compte dans une comparaison, il faut la conserver dans un relevé séparé.
Cet ensemble n’est pas non plus équivalent à la liste de candidats de la ligne collective. Les tableaux candidats de getPrediction répondent à la question de savoir si une valeur unique peut être renvoyée pour un hash. Les ensembles de collecteurs de renderPrediction combinent des valeurs issues d’objets de signaux pour produire un résumé visible. Utiliser un seul mot comme « consensus » pour les deux chemins masquerait cette différence.
Les 18 champs source peuvent être regroupés selon la surface qu’ils nomment, mais ces étiquettes n’impliquent ni qualité égale ni indépendance. Canvas image, Canvas paint, Canvas text et Canvas emoji sont des entrées distinctes dans le code. gpuSystem et gpuModelSystem le sont aussi. Les traiter comme des votes totalement indépendants ajouterait une hypothèse statistique absente de l’implémentation.
Séparer le choix de l’appareil des états de score
Avant le rendu de l’étiquette de l’appareil, l’interface calcule une sélection spéciale Windows Remote Firefox Privacy. La source compte les chaînes d’appareil contenant « Windows » et divise ce nombre par celui de toutes les chaînes. Cette branche ne s’active que si la proportion dépasse 0.5; elle essaie alors un ordre fixe : Windows 7, Windows 8, Windows 8.1, Windows 11, puis Windows 10, en vérifiant d’abord la variante 64 bits pour chaque version. Si la proportion ne dépasse pas la moitié, l’assistant renvoie undefined.
Le deviceName final correspond au résultat de l’assistant RFP ou, si ce résultat est falsy, au nom de base commun des appareils. Le commentaire indique que les échantillons ignorent Firefox RFP parce qu’il renvoie Windows 10, puis explique l’ordre préféré lorsque plusieurs versions de Windows sont présentes. C’est une règle d’affichage propre à cette source. Elle ne prouve pas que la population générale suit cet ordre et ne doit pas être présentée comme un détecteur de système d’exploitation généralement précis.
crowdBlendingScoreGrade associe des lettres à des plages numériques : A à partir de 90, B à partir de 80, C à partir de 70, D à partir de 60 et F en dessous de 60. Le balisage affiche un pourcentage et une lettre uniquement si crowdBlendingScore a le type JavaScript number. Une branche bot distincte affiche « locked ». Le code définit un mappage de notes et une condition d’interface ; il ne précise pas ce que le score prédit ni comment il est calibré.
Le module affiche pendingReview dans une note distincte lorsque le champ est truthy. Cette étiquette doit être enregistrée séparément du score et du nom prédit. La source figée ne permet pas de la remplacer par « échec », « approuvé » ou « examen humain terminé » sans une autre source définissant précisément cet état.
Plusieurs détails d’affichage peuvent être consignés sans en faire des affirmations de confiance :
| État visible | Condition source | Lecture limitée |
|---|---|---|
** avant l’étiquette combinée | deviceName et gpuBrandName sont truthy | Le rendu dispose des deux chaînes. Les étoiles ne sont pas une probabilité. |
* avant une seule étiquette | Une seule des deux chaînes d’affichage est truthy | Ce chemin dispose d’une de ces deux chaînes. |
| Icônes de prédiction vides | Aucune des deux chaînes n’est truthy | Ce chemin n’affiche pas l’étiquette combinée. |
pending review: … | pendingReview est truthy | Le champ fourni est affiché ; la source figée ne définit pas le résultat de l’examen. |
| Score et lettre de mélange collectif | Le score est de type number et la branche de verrouillage est fausse | L’interface affiche le nombre fourni avec une bande de note ; la précision est inconnue. |
locked | La branche bot est truthy | L’interface emprunte la branche verrouillée et n’y affiche pas le score. |
L’assistant hasValue demande une précaution supplémentaire. Il recherche la première valeur de propriété dont le type n’est pas undefined ; les appels nient ensuite le résultat pour choisir unknownHTML. Une valeur définie false ou 0 est elle-même falsy et peut donc entrer dans la branche d’affichage inconnue. Ce comportement signifie qu’une étiquette « unknown » ne prouve pas que le collecteur ne s’est pas exécuté. Elle peut refléter la façon dont cet assistant traite une valeur falsy. Cette observation se limite à l’implémentation figée et doit être vérifiée si une révision ultérieure change l’assistant.
predictionErrorPatch est une autre branche. Appelé avec une erreur et si l’élément de prédiction existe, il rend « Prediction Failed » et des icônes vides sur de nombreuses lignes. Ce marqueur décrit l’interface d’erreur, pas la règle de nombre de candidats ni une exécution réussie où tous les signaux seraient absents. Un relevé devrait distinguer cette branche d’erreur d’un rapport normal où des lignes individuelles apparaissent comme inconnues.
Conserver un relevé de comparaison lié à la source
Lorsque deux rapports diffèrent, consignez d’abord la question et la révision de la source avant d’interpréter les étiquettes. Ces champs préservent les distinctions de l’implémentation sans copier de hash brut ni recueillir un identifiant complet de navigateur :
| Champ du relevé | À conserver | Pourquoi c’est utile |
|---|---|---|
| Source | Dépôt, SHA du commit et chemin du fichier | Une révision ultérieure peut changer la recherche ou le rendu. |
| État de recherche | Présence ou absence d’une ligne correspondant au hash dans les données fournies ; ne pas enregistrer le hash lui-même | La présence d’une ligne et l’unicité d’un champ sont des résultats distincts. |
| Nombre de candidats | Comptes pour systèmes, appareils, GPU et marques de GPU | Les règles de retour dépendent de la longueur du tableau et d’une base commune d’appareil. |
| État d’agrégation | Champs de collecteurs nommés présents et nombre de valeurs uniques par ensemble | Un ensemble dédupliqué ne conserve pas sa liste initiale de contributeurs. |
| État de rendu | Marqueur de prédiction, branche unknown, pendingReview, score numérique, verrouillage ou marqueur d’erreur | Des zones vides qui se ressemblent peuvent provenir de chemins différents. |
| Limites | Lecture d’une source figée, observation actuelle de la page ou autre source explicitement bornée | Le code seul ne prouve pas la sortie actuelle du service ni sa précision. |
N’enregistrez pas le hash fourni simplement parce que la recherche l’utilise. Un booléen indiquant la présence d’une ligne correspondante et les comptes de candidats suffisent généralement pour répondre à la question. Conserver un identifiant brut augmenterait les données stockées sans améliorer l’explication du chemin suivi.
Utilisez cette feuille pour interpréter et comparer le comportement de sources publiques. Ce n’est ni un protocole de reproduction du backend CreepJS, ni un benchmark de sa précision, ni une méthode pour modifier le score d’un tiers. Ces affirmations nécessiteraient des éléments différents de ceux fournis par ce fichier source.
Sources
- Module de prédiction CreepJS au commit
10aa6724cd33a1015db1574211890518cd04f0cc: recherche, réduction des candidats, agrégation, états unknown, affichage du score et marqueur d’erreur. - BotBrowser : menaces liées à l’empreinte et à la vie privée : contexte général des signaux et de la confidentialité, pas l’implémentation de prédiction CreepJS.
- BotBrowser : cohérence de l’automatisation : manière d’examiner ensemble les surfaces de configuration visibles par le navigateur ; ne définit pas la décision d’un détecteur tiers.
Practical conclusion
Lisez le panneau de prédiction CreepJS comme un ensemble de sorties dépendantes de la source. Vérifiez d’abord si les données collectives contiennent une ligne correspondante, puis conservez séparément les comptes de candidats, les valeurs uniques des collecteurs et l’état d’affichage. Une valeur unique renvoyée, une base commune d’appareil, une bande de score, une note d’examen en attente et un marqueur inconnu ne sont pas des preuves interchangeables. Le code figé explique l’assemblage de ces étiquettes ; il n’en fait ni une identité d’appareil vérifiée ni un jugement de bot calibré.
Cet article fait partie du guide : Qu'est-ce qu'une empreinte de navigateur ?
Articles Connexes
Signaux Math de CreepJS : lire les champs
EmpreinteRapport WebGL de CreepJS : contextes et signaux
EmpreinteRapport WebGL BrowserLeaks : collecte et champs absents
EmpreinteMétriques emoji CreepJS : ensembles et sommes
EmpreinteRapports audio CreepJS : rendu et valeurs absentes
EmpreinteTables CreepJS : 51 noms et 14 retours possibles
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.