Champs du rapport WebRTC de BrowserLeaks
Reliez les champs WebRTC de BrowserLeaks aux opérations du navigateur sans transformer une ligne en verdict de fuite.
BotBrowser Team
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
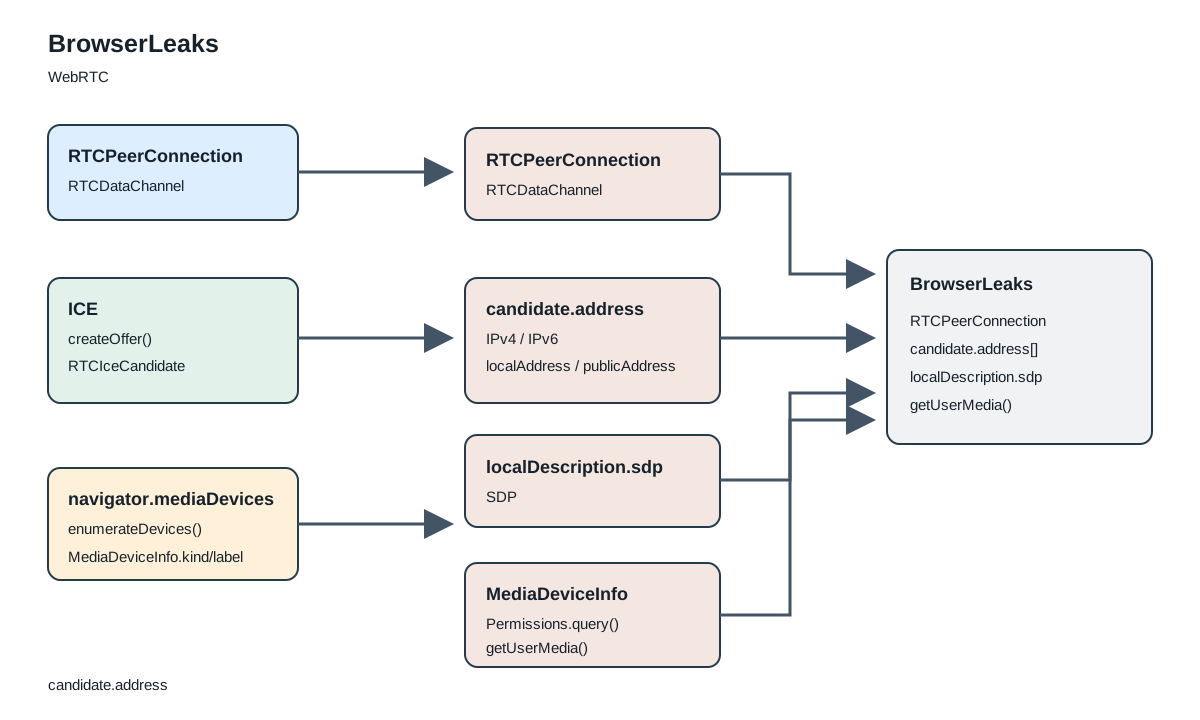
Le test WebRTC de BrowserLeaks présente plusieurs observations distinctes : la disponibilité d’interfaces, des candidats ICE recueillis, une description de session et l’état des périphériques multimédias. BotBrowser documente le contrôle d’ICE et des périphériques multimédias, mais ne garantit pas que cette page valide ses réglages ou ses conclusions. Aucune ligne ne prouve une identité, l’anonymat ou une fuite universelle. La lecture utile consiste à relier chaque ligne à l’opération qui l’a produite, puis à garder les éléments de chaque chemin séparés.
Résumé
La page publique de BrowserLeaks affiche des vérifications d’interface, un résultat de collecte ICE, un journal SDP et des informations sur les périphériques multimédias. Son script, dont l’URL de page comporte un identifiant de version, crée une RTCPeerConnection, demande une offre, écoute les événements de candidats, puis interroge séparément les périphériques et les permissions. Une adresse de candidat, un indicateur de prise en charge, un état de permission ou une ligne de périphérique décrit cette opération dans ce contexte ; ce n’est ni une description complète d’un chemin réseau ni l’identité d’une personne.
Sommaire
- Le rapport rassemble plusieurs chemins, pas un score
- La prise en charge et la collecte de candidats répondent à des questions différentes
- Les libellés des candidats projettent les données recueillies
- Le journal SDP n’est pas une capture de paquets
- Périphériques, permissions et capture restent distincts
- Table des champs et des opérations
- Ce que le rapport ne peut pas établir
- Conclusion pratique
Le rapport rassemble plusieurs chemins, pas un score
La page WebRTC de BrowserLeaks présente des sections distinctes au lieu d’un score numérique unique. Les titres visibles couvrent la prise en charge WebRTC, des champs d’adresse locale et publique, une description de session et les périphériques multimédias. Des boutons séparés demandent aussi l’autorisation de capture audio ou vidéo. Cette disposition est importante : chaque section est alimentée par une opération différente exposée par le navigateur ; la valeur d’une section ne fait pas réussir automatiquement les autres opérations.
La page charge un script client public dont l’URL porte actuellement le jeton de version 86970852. Ce script permet de décrire le comportement de la page ; ce n’est ni une norme WebRTC ni un dépôt de code audité. Une version ultérieure pourrait modifier les champs, les délais ou les règles d’analyse. Le HTML visible et le script répondent donc à une question limitée : quelles opérations cette version récupérée demande au navigateur, et où elle place les valeurs obtenues. Ils ne prouvent pas le comportement de tous les navigateurs, réseaux, extensions ou versions futures de BrowserLeaks.
Cette approche diffère de la documentation BotBrowser sur la prévention des fuites WebRTC, qui décrit les commandes ICE et SDP, et de la documentation sur les périphériques multimédias, qui présente l’énumération adossée au profil. Ici, le sujet est le rapport BrowserLeaks lui-même. L’analyse distincte des champs WebRTC de CreepJS suit les transformations d’un autre collecteur ; ses noms de champs et ses branches ne doivent pas être transposés à BrowserLeaks.
Garder ce périmètre précis évite une erreur d’interprétation fréquente. Le rapport peut afficher RTCPeerConnection: True avec une zone d’adresse vide, ou une liste de périphériques tandis qu’une demande de capture est en attente ou refusée. Ces états ne se contredisent pas. La disponibilité indique qu’une interface a été trouvée ; la collecte et les permissions sont des opérations ultérieures qui ont leurs propres résultats.
La prise en charge et la collecte de candidats répondent à des questions différentes
La page publique affiche deux lignes de prise en charge : RTCPeerConnection et RTCDataChannel. Dans le script versionné, le constructeur essaie les noms standard et préfixés dans le contexte de la page et dans une iframe isolée. Il vérifie ensuite si l’objet obtenu expose createDataChannel. Ce sont des vérifications de disponibilité de l’interface. Elles ne créent pas de route réseau, ne prouvent pas que la collecte ICE s’est achevée et ne montrent pas qu’un pair distant a reçu des données.
La collecte de candidats suit un autre chemin. Le script crée une peer connection avec le serveur STUN public de Google stun:stun.l.google.com:19302, crée un canal de données lorsque cette méthode existe et demande une offre. L’offre demande la réception audio et vidéo ; si cette forme échoue, le script essaie une offre plus simple. Lorsque le navigateur accepte l’offre localement, le script la définit comme description locale et traite les événements de candidats. Ces appels expliquent pourquoi la page peut afficher des informations liées aux candidats sans qu’une application ait lancé d’appel ; ils ne testent pas toutes les applications, configurations TURN ni sessions entre pairs.
Le script recueille des valeurs à la fois dans l’événement icecandidate et dans les lignes de forme candidate de localDescription.sdp. Il déduplique les chaînes d’adresse analysées, attend la fin du chemin ou sa branche d’expiration, écrit le SDP dans le journal visible, puis ferme la peer connection. Le flux d’événements et la représentation SDP sont deux vues liées d’une négociation, pas deux analyses réseau indépendantes. Une valeur répétée dans les deux vues ne doit pas être comptée comme deux interfaces ou deux fuites.
L’API du navigateur définit le rôle d’une RTCPeerConnection et de son échange ICE ; la page choisit les appels et les valeurs qu’elle affiche. La spécification W3C WebRTC et la référence RTCPeerConnection de MDN décrivent le contrat d’interface. Les choix propres au test, comme le serveur STUN, l’offre de secours, le délai de collecte et le texte affiché, viennent du script BrowserLeaks. Une norme qui décrit un événement candidat ne certifie ni son classement ni la conclusion du rapport.
Les libellés des candidats projettent les données recueillies
La page affiche des zones d’adresse locale et publique. Le script client recueille les valeurs des événements icecandidate et de localDescription.sdp, extrait les textes ayant la forme d’une adresse, les compare à une liste de plages locales puis place les valeurs uniques dans deux groupes. L’analyse du regroupement des candidats ICE précise pourquoi leur moment d’apparition compte. Il s’agit d’une projection propre au rapport, pas de l’objet ICE complet, d’une capture de paquets ni d’un inventaire de toutes les adresses accessibles au système d’exploitation.
Cette distinction compte lorsque le résultat est vide. Le script peut ne recevoir aucun candidat reconnu par son analyseur, le navigateur peut appliquer un comportement de confidentialité, la route choisie peut ne pas produire l’adresse attendue, ou le rapport peut atteindre une branche de délai ou d’erreur. Une zone vide signifie que cette version n’a affiché aucune valeur analysée dans ce champ pendant cette exécution. Elle ne prouve pas que la machine n’a pas d’adresse locale, qu’aucun chemin réseau n’existe ou que tous les observateurs distants voient la même chose.
De même, une valeur dans le groupe local n’identifie pas automatiquement une interface physique. La vérification des plages répond seulement à la question de savoir si le texte analysé correspond aux règles locales du script. Elle ne dit pas quel adaptateur a fourni l’adresse, qui le contrôle ou si un pair séparé peut l’utiliser. Les valeurs du groupe public sont les libellés du rapport pour les adresses qui ne correspondent pas à ces règles locales ; elles ne constituent pas une carte complète de l’accessibilité publique et ne prouvent pas qu’un proxy a été contourné.
L’analyse est également destructive. Elle recherche des sous-chaînes de forme IPv4 ou IPv6 au lieu de conserver un enregistrement candidat typé avec tous les champs associés. Le collecteur n’affiche pas, à côté de chaque adresse, un objet de provenance permettant de reconstruire sa foundation, son transport, son composant, son adresse associée ou le choix de la paire candidate. Une liste d’adresses uniques ne répond pas à ces questions omises. Quand une application doit diagnostiquer ICE, sa propre paire candidate sélectionnée et ses statistiques de connexion constituent d’autres éléments, avec un périmètre et des permissions différents.
La page BrowserLeaks est utile comme surface d’observation publique parce qu’elle montre ce que son test actuel recueille. Ce n’est pas un verdict de détecteur général. Dans une analyse de confidentialité, séparez la source des données (événement ou SDP), l’analyseur (extraction d’adresse), la règle de classement (correspondance à une plage locale) et le champ affiché. Résumer ces étapes par « le navigateur a fui » efface ce que la page a réellement observé.
Le journal SDP n’est pas une capture de paquets
La section Session Description contient un journal SDP tiré de localDescription.sdp. SDP est une description textuelle utilisée pendant la négociation. Elle peut contenir des sections média, des attributs de codec, des paramètres ICE et des lignes de candidats ; les champs exacts dépendent de ce que crée le navigateur et de ce qui a été recueilli quand le rapport les lit. Ce n’est pas un relevé des paquets transmis sur le réseau et cela ne prouve pas qu’un pair distant ait reçu, accepté ou utilisé chaque ligne.
Le script normalise si nécessaire la ligne de version SDP initiale, puis affiche la description locale dans une zone de texte. Ce texte relève de l’état de négociation local du navigateur. Il est distinct des listes d’adresses calculées par le rapport : le même texte candidat peut apparaître dans le journal SDP et être analysé dans un groupe local ou public. Considérer le journal brut et la liste classée comme deux confirmations indépendantes compterait deux fois une seule source.
Le journal ne montre pas non plus toutes les propriétés d’un appel réel d’application. Cette page crée sa propre peer connection, sa propre offre et sa propre configuration ICE. Une application de visioconférence peut utiliser une autre offre SDP, d’autres serveurs ICE, une politique de relais, un autre cycle d’appel ou un contexte d’origine et de permissions différent. Le résultat BrowserLeaks ne s’étend pas à ces conditions sans preuve issue de ce chemin applicatif.
Une lecture bornée du journal pose trois questions. Quel texte était présent dans la description locale ? Quelles lignes ce script a-t-il analysées comme chaînes en forme d’adresse ? Quelles valeurs analysées sa vérification de plages a-t-elle placées dans un groupe affiché ? Cette zone de texte seule ne permet pas de répondre à la question de savoir si un pair a reçu un paquet. Il faut des éléments de transport ou d’application que ce champ ne présente pas.
Périphériques, permissions et capture restent distincts
La section Media Devices est une branche différente de la collecte de candidats ICE. Le script client vérifie la présence de navigator.mediaDevices.enumerateDevices() et l’appelle si elle est disponible. Pour chaque MediaDeviceInfo, il formate kind, label, deviceId et groupId. Il note séparément si les lignes d’entrée audio et vidéo ont une étiquette non vide. Le navigateur peut exposer des nombres et des libellés différents selon le contexte, les permissions, les règles et l’implémentation ; ces lignes ne sont pas un inventaire du matériel.
La page interroge aussi l’état des permissions du microphone et de la caméra avec navigator.permissions.query() lorsque l’API et le nom de permission sont pris en charge. Ces valeurs sont présentées séparément des lignes de périphériques. La prise en charge des requêtes de permission peut varier, et une requête rejetée ou non prise en charge n’équivaut pas à une permission refusée. L’état prompt n’est pas une autorisation de capture. Une étiquette vide ne prouve pas l’absence du périphérique ; elle peut refléter les règles de divulgation ou l’état de permission actuel.
Les captures audio et vidéo sont des actions explicites distinctes. Les boutons de la page appellent getUserMedia() avec une demande audio seule ou vidéo seule. Le script met à jour la zone correspondante selon que la promesse aboutit ou échoue. L’énumération n’ouvre pas automatiquement le microphone ou la caméra, et un état de permission ne prouve pas qu’un flux utilisable puisse être obtenu. À l’inverse, la réussite d’une demande de capture pour un type ne signifie pas que l’autre soit autorisé ou disponible.
Cette séparation correspond au modèle des API navigateur. La référence enumerateDevices de MDN décrit une liste filtrée par les permissions et les politiques ; la référence getUserMedia décrit une demande qui peut afficher une invite, être refusée ou renvoyer un flux. Le rapport expose les deux surfaces parce qu’elles répondent à des questions proches mais différentes. Son interface ne transforme pas une ligne de périphérique en résultat de capture.
Le guide BotBrowser des périphériques multimédias décrit la différence entre l’énumération adossée au profil et les périphériques réels du système. Ce réglage ne crée pas de caméra physique, n’accorde pas les permissions du système d’exploitation et ne garantit pas une étiquette particulière dans BrowserLeaks. Le guide de configuration WebRTC décrit lui aussi le comportement réseau, pas la capture média. Garder ces contrôles séparés évite de confondre un réglage de profil avec une permission utilisateur ou une entrée utilisable.
Table des champs et des opérations
Le tableau résume les champs visibles du rapport et l’opération qui les alimente. C’est une aide à la lecture de cette version de la page, pas une procédure de reproduction d’une analyse réseau ni l’affirmation que chaque ligne constitue une caractéristique de détecteur.
| Champ visible | Opération de la page | Ce que le champ étaye | Ce qu’il ne démontre pas |
|---|---|---|---|
RTCPeerConnection | Recherche du constructeur dans la page et dans une iframe isolée | Si un constructeur pris en charge a été trouvé dans ce contexte | Que la collecte réussit ou qu’une connexion atteint un autre hôte |
RTCDataChannel | Vérification de createDataChannel sur l’objet construit | Si la méthode est exposée sur cet objet | Qu’un canal de données a été ouvert avec un pair distant |
Local IP Address / Public IP Address | Analyse des candidats et du SDP, déduplication, classement par plage locale | Quelles chaînes analysées le rapport a placées dans chaque groupe | Un inventaire complet des interfaces, une route complète, une identité physique ou un verdict universel de fuite |
SDP Log | Lecture de localDescription.sdp après la création d’offre | Le texte présent dans la description locale de cette page | Une capture de paquets, une réponse distante ou un échange média réussi |
API Support dans Media Devices | Vérification de enumerateDevices() | Si la méthode existe avant l’énumération | Si un périphérique existe ou peut être ouvert |
| Lignes de périphériques | Formatage du résultat enumerateDevices() | Les valeurs retournées de kind, label, deviceId et groupId | Tout le matériel connecté ou une identité permanente de périphérique |
| Permission audio/vidéo | permissions.query() pour le nom correspondant | L’état renvoyé par la requête | Un flux accordé, une prise en charge uniforme ou un périphérique utilisable |
| Capture audio/vidéo | Demande getUserMedia() déclenchée par l’utilisateur | Si cette demande a abouti ou échoué dans le contexte actuel | L’autre type de média, les permissions futures ou la qualité d’un appel distant |
Les lignes doivent rester indépendantes au moment de résumer un résultat. Par exemple, RTCPeerConnection: True, aucune adresse affichée et enumerateDevices(): True peuvent coexister : ils décrivent la présence d’une interface, un chemin d’analyse sans valeur affichée et une API média séparée. Une note qui transforme tout cela en un seul « réussi » ou « échoué » efface l’opération à l’origine de chaque observation.
Ce que le rapport ne peut pas établir
Le rapport WebRTC n’identifie pas une personne. Les adresses de candidats peuvent être partagées, réattribuées, traduites, relayées, masquées ou indisponibles pour une page. Les identifiants et libellés de périphériques multimédias sont des valeurs contextuelles du navigateur, pas une preuve du propriétaire d’un appareil physique. Un rapport visible dans le navigateur n’authentifie pas un compte, n’identifie pas une application intégrant un WebView et ne détermine pas ce qu’un serveur a conservé après une requête.
Le rapport n’établit pas l’anonymat. Un champ d’adresse n’est qu’une surface observable ; la page ne mesure pas toutes les routes réseau ni tous les signaux du navigateur. Une zone d’adresse vide ne prouve pas qu’une route réseau soit saine, et une adresse publique n’est pas, à elle seule, la preuve qu’un proxy a été contourné. Une affirmation sur la confidentialité réseau exige un observateur et un contexte de test définis.
Il ne prouve pas non plus qu’un navigateur « passe » un détecteur de bots. BrowserLeaks est une page de diagnostic publique, pas une norme universelle pour décider du trafic automatisé. Un champ peut être collecté pour le dépannage ou la transparence sans qu’un service anti-bot particulier l’utilise. Aucun résultat fournisseur, défi ou taux d’acceptation ne découle du rapport seul.
Enfin, le rapport dépend du moment et du contexte. La version du navigateur, les permissions d’origine, la route réseau, la disponibilité de STUN, les politiques, les extensions et les changements du script peuvent modifier le résultat visible. Le jeton de version dans l’URL du script identifie la ressource récupérée au moment de l’inspection ; il ne garantit pas que chaque visite future reçoive le même code. Il vaut donc mieux citer la page publique avec la date de consultation et la section lue que la traiter comme une spécification immuable.
FAQ
Le test WebRTC de BrowserLeaks révèle-t-il toujours une adresse publique ?
Non. La page peut afficher une adresse analysée lorsque son opération reçoit un texte de candidat ou de SDP reconnu par son analyseur et que le test atteint le chemin d’affichage. Une zone vide peut avoir plusieurs causes ; elle ne prouve pas qu’aucune autre adresse ou route n’existe.
RTCPeerConnection: True prouve-t-il qu’un appel WebRTC fonctionne ?
Non. C’est une vérification de disponibilité. La collecte de candidats, la connectivité ICE, la négociation distante et le transfert de média sont des étapes ultérieures. La ligne de prise en charge ne représente pas un appel terminé avec un autre pair.
La liste de périphériques signifie-t-elle que le microphone est actif ?
Non. enumerateDevices() renvoie une liste filtrée par le navigateur. Les boutons de capture de la page lancent des demandes getUserMedia() distinctes, qui peuvent réussir ou échouer indépendamment. Une ligne de périphérique ne prouve pas qu’une capture a commencé.
La page BrowserLeaks est-elle un détecteur open source ?
La page et son script peuvent être récupérés publiquement, ce qui permet d’inspecter le comportement affiché. Cela ne prouve pas l’existence d’une licence open source ou d’un dépôt sous licence. Ici, BrowserLeaks est décrit comme une page publique avec un script public, pas comme un projet dont la licence du code source est connue.
Le résultat indique-t-il si un navigateur est détectable ?
Non. Il montre certaines observations WebRTC et média. D’autres pages et services peuvent utiliser d’autres API, politiques ou signaux serveur ; ce rapport ne communique pas leurs décisions.
Sources
- BrowserLeaks WebRTC Leak Test et son script client portant la version de la page.
- W3C WebRTC 1.0 et la référence RTCPeerConnection de MDN.
- MediaDevices.enumerateDevices() de MDN et MediaDevices.getUserMedia().
- Prévention des fuites WebRTC BotBrowser et Confidentialité des périphériques multimédias.
Conclusion pratique
Lis la page WebRTC de BrowserLeaks comme un ensemble de résultats indépendants. Relie les indicateurs de prise en charge aux vérifications de constructeurs, les groupes d’adresses à l’analyse des candidats et du SDP, le journal de session à la description locale, les lignes de périphériques à l’énumération, les libellés de permission aux requêtes correspondantes et les résultats de capture aux appels explicites à getUserMedia(). Le rapport donne une vue utile de ces opérations dans le contexte de sa propre page. Il ne les transforme pas en identité personnelle, garantie d’anonymat, verdict universel de fuite ou prédiction d’une décision anti-bot.
Cet article fait partie du guide : Qu'est-ce qu'une fuite d'IP WebRTC ? Prévention et vie privée
Articles Connexes
Rapport WebRTC CreepJS : origine des champs
RéseauQu'est-ce qu'une fuite d'IP WebRTC ? Prévention et vie privée
EmpreinteWebRTC : cycle et temporalité du pool ICE
EmpreinteRapport Canvas de BrowserLeaks : signaux et limites
RéseauCandidats mDNS WebRTC et confidentialité du réseau local
EmpreinteFingerprinting codecs WebRTC : fuite de capacites
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.