Listas de voces de Speech Synthesis: guía de diagnóstico seguro
Resuelve listas de voces vacías, coincidencia de idioma, colas de voz y errores sin tratar las voces como una señal de identidad.
BotBrowser Team
Prefieres la documentación del producto mantenida?
Este artículo tiene una página equivalente en el centro de documentación. Usa los docs para el flujo canónico, las flags actuales y la referencia duradera.
El modo de perfil de BotBrowser controla los metadatos de voz expuestos, pero no garantiza que el sistema anfitrión pueda producir audio audible.
Si el selector de voces del navegador está vacío, no concluyas de inmediato que la API no es compatible ni sigas consultándola sin límite. Lee getVoices(), suscríbete a voiceschanged para actualizar la lista durante un periodo acotado y, si no aparece una voz adecuada, conserva el texto legible y ofrece reintentar o usar el idioma de la aplicación como alternativa. Inicia la reproducción a partir de una acción deliberada de la persona, resuelve la voz elegida frente a la lista actual y trata la finalización de la cola, la cancelación y los errores como estados normales de la aplicación. Los metadatos disponibles pueden variar; no constituyen una identidad estable del dispositivo ni un catálogo común a todos los sistemas operativos.
Resumen
getVoices()puede devolver un array vacío en un momento dado. Trátalo como un estado de carga o disponibilidad y vuelve a consultar trasvoiceschanged; no presupongas un número ni un plazo fijo para los eventos.name,lang,localService,defaultyvoiceURIresponden a preguntas distintas. Elige una voz para la tarea y el idioma de la persona, no según una secuencia supuesta del sistema operativo.speak()añade una locución a la cola. Una actualización de la lista no justifica volver a encolar la misma locución: actualiza la selección y deja que la persona decida si quiere iniciar o repetir la reproducción.- Invoca la reproducción mediante una acción visible de la persona, pero no prometas que todos los navegadores muestran el mismo diálogo de permisos o aplican la misma política de activación. Conserva el texto original y ofrece un estado de error que permita reintentar.
- Una lista de voces puede revelar contexto del entorno sin identificar a una persona. Recopila solo los diagnósticos necesarios y no transmitas por defecto el inventario completo.
Contenido
- Qué expone la API
- Regla de selección campo por campo
- Árbol de fallos de un selector de voz
- Actualización y estados de la cola
- Alternativas de idioma y activación del usuario
- Cancelación, errores y límites de privacidad
- Qué aporta esta guía frente a la configuración
- Conclusión práctica
Qué expone la API
La Web Speech API separa el descubrimiento de voces de la salida hablada. window.speechSynthesis es el controlador: expone la lista de voces actual, una cola y métodos como speak(), cancel(), pause() y resume(). Un SpeechSynthesisUtterance contiene el texto y los ajustes opcionales de una solicitud. La aplicación puede leer los metadatos de las voces antes de pedirle al controlador que hable; enumerarlas no requiere reproducir audio. La API no incluye una solicitud independiente de permiso del usuario para leer la lista con getVoices(); las políticas para iniciar la reproducción de audio son un asunto distinto.
La lista depende del contexto, no es universal. Un navegador puede integrarse con servicios de voz del sistema operativo, con un servicio administrado por el propio navegador o con ambos. Los recursos de idioma instalados y las decisiones del navegador pueden influir en lo que se expone. Incluso en el mismo equipo, dos productos o versiones de navegador no tienen por qué devolver una colección idéntica. El equipo también puede cambiar cuando se instala un paquete de idioma o un servicio. Por eso, no publiques una tabla que atribuya a cada instalación de Windows, macOS, Linux o móvil un número, una marca, un orden o unos nombres fijos.
La primera llamada no es una prueba fiable de que la API esté lista. MDN documenta que getVoices() devuelve las voces que el servicio de síntesis tiene disponibles en ese momento y documenta el evento voiceschanged cuando cambia esa lista. En algunos entornos, la aplicación observa primero una lista vacía y después un evento de cambio; en otros, ya hay entradas en la primera lectura. La API no ofrece un plazo universal tras el cual la lista deba estar completa. Una página debe admitir tanto la lista inmediata como la actualización posterior, en vez de convertir un momento concreto en una garantía de compatibilidad.
Esta superficie importa para la privacidad porque los nombres, la cobertura lingüística, los indicadores de localidad y el comportamiento de los cambios pueden añadir contexto a otras señales del navegador. Para entender el concepto general de combinar atributos distintos del navegador, consulta la explicación de las huellas digitales del navegador. Que un conjunto pueda ser distintivo no demuestra que un sitio lo use, que identifique a alguien ni que una propiedad concreta corresponda a un sistema operativo. Un selector de voz necesita mostrar solo lo necesario para ayudar a elegir; por lo general, las analíticas no necesitan la lista completa.
Regla de selección campo por campo
Los objetos de voz exponen campos con finalidades distintas. Un selector útil no los trata como identificadores intercambiables.
| Campo | Pregunta útil para la aplicación | Regla de selección | Qué no se debe inferir |
|---|---|---|---|
lang | ¿Qué idioma o configuración regional representa? | Compara las etiquetas de idioma con la configuración solicitada por la aplicación; prioriza la coincidencia exacta y luego una alternativa deliberada a nivel de idioma. | Que la etiqueta coincida no garantiza que el texto esté traducido o se pronuncie como se espera. |
name | ¿Qué etiqueta permite distinguir las opciones? | Cuando haga falta elegir, muestra una etiqueta breve y escapada; mantenla local salvo que el soporte técnico requiera lo contrario. | Un nombre parecido a una marca no demuestra el sistema operativo, el dispositivo ni la identidad de una persona. |
localService | ¿La API describe el servicio como local? | Úsalo solo si hay una razón visible para explicar el comportamiento de un servicio local o remoto. | true no promete privacidad de red ni que la reproducción vaya a funcionar. |
default | ¿Qué voz marca la implementación como predeterminada? | Si la persona aún no eligió, úsalo para desempatar entre voces que ya sean adecuadas. | La opción predeterminada no tiene por qué ser el idioma preferido de la aplicación ni la mejor para el texto actual. |
voiceURI | ¿La implementación proporciona un URI para la voz? | Trátalo como un valor opaco; evita guardarlo o usarlo como clave entre sesiones. | No se garantiza que sea globalmente estable, portable o significativo fuera de esa implementación. |
La tabla ayuda a decidir, pero no enumera firmas de plataformas. En una instalación, name puede ser legible; en otra, el identificador puede ser opaco. La aplicación no debe analizar el nombre para deducir un proveedor. Un valor de localService describe el objeto de voz según la implementación, no toda la ruta que siga cada solicitud. Del mismo modo, default expresa una preferencia de la implementación, no un algoritmo de negociación de idioma para la página.
Empieza por el requisito real de la aplicación. Si debe leer texto en español, selecciona voces cuyo lang coincida lo mejor posible con la variante solicitada dentro de la lista actual. Si hay varias coincidencias, aplica una elección explícita de la persona o un desempate predecible, como default. Si la página solo necesita ofrecer un botón de reproducción y no tiene un menú de voces, quizá no necesite mostrar ni guardar los nombres. Como ejemplo relacionado de cómo mantener en contexto las propiedades de plataforma declaradas, consulta las propiedades de navigator y el contexto de plataforma; ninguna de estas superficies debe usarse como clave de identidad personal.
No presupongas un orden estable como «la voz cero es la predeterminada del sistema» o «la primera entrada en inglés es igual en todos los equipos». El orden del array no es un contrato de selección portable. La actualización también puede producir un array nuevo, así que la aplicación debería conservar una preferencia comprensible para la persona, como el idioma solicitado o la opción seleccionada localmente, y después resolver esa preferencia frente a los objetos actuales. Si la opción anterior ya no está, explícalo y ofrece las coincidencias restantes en vez de seleccionar en silencio una voz distinta.
Árbol de fallos de un selector de voz
La siguiente ruta de decisión mantiene útil la aplicación sin convertir un estado transitorio de la API en una afirmación sobre el navegador o el dispositivo:
- ¿Está presente
speechSynthesis? Si no, conserva el contenido escrito e indica que la lectura en voz alta no está disponible en este contexto. No ocultes ni reemplaces el texto. - ¿Devuelve entradas
getVoices()ahora? Si sí, muestra opciones de la lista actual. Si no, registra un solo listener devoiceschanged, vuelve a leer cuando se dispare y deja de esperar tras un tiempo de espera definido por la aplicación. No crees un listener nuevo en cada renderizado. - ¿La actualización proporcionó un
langadecuado? Si sí, conserva la selección de la persona mientras siga coincidiendo. Si desapareció, borra la selección obsoleta y explica las alternativas disponibles. Si no coincide ninguna voz, usa la alternativa explícita de idioma de la aplicación o pide que se elija; no deduzcas un idioma a partir del nombre de una voz. - ¿La persona activó la reproducción? Si sí, crea una locución nueva con la opción actual y llama a
speak(). Si no, espera. Así la función queda bajo el control de la persona y no depende de que se permita la reproducción automática. - ¿Qué ocurrió con la locución? En
end, muestra el estado inactivo o completado. Enerror, ofrece un mensaje breve que permita reintentar y conserva el texto. Ante una detención explícita, cancela la cola y limpia el estado activo de la interfaz. - ¿Cambió la lista durante la reproducción? Actualiza el selector, pero no dupliques la locución activa. Antes de una repetición posterior, resuelve la opción preferida frente a la lista más reciente.
Un array vacío después de una espera acotada admite varias explicaciones: quizá la síntesis de voz no esté disponible en ese contexto, un servicio no haya proporcionado entradas, la aplicación esté buscando el idioma equivocado o la inicialización no haya terminado como se esperaba. Cada posibilidad requiere acciones distintas para la persona. Un mensaje genérico de «huella digital no coincidente» no ayuda ni está justificado. En cambio, «Ahora mismo no hay una voz disponible en francés» indica una acción posible y no revela todo el inventario.
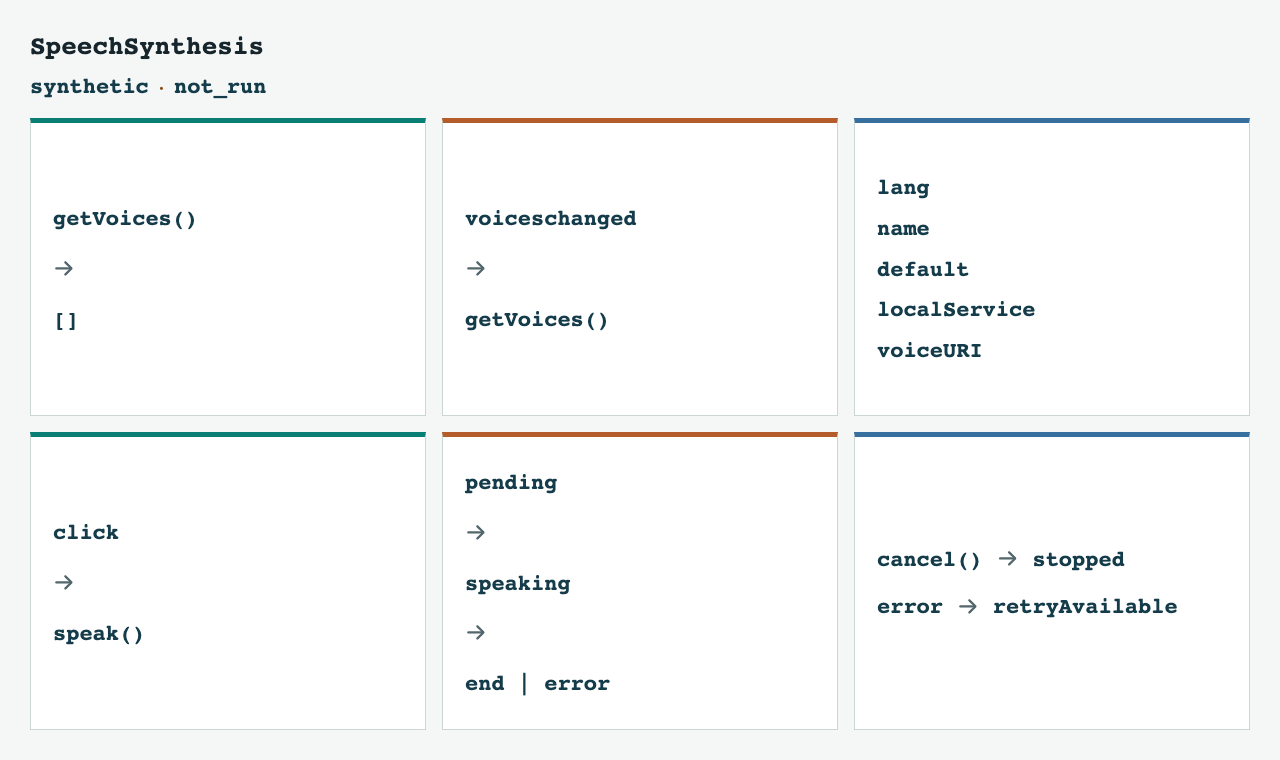
El diagrama de rutas de fallo del selector de voz que aparece arriba resume estas ramas en seis estados de aplicación. Es una ayuda ilustrativa para decidir, generada desde un fixture HTML local, no una medición capturada de un navegador. La conclusión clave es que la interfaz siempre conserva una alternativa textual, tanto si la lista llega al instante, cambia más tarde o permanece vacía.
Decidir cuándo termina una espera
| Evidencia de que la lista sigue cargando | Lo que prueba y lo que no |
|---|---|
getVoices() devolvió un array vacío en el primer renderizado | No es definitivo por sí solo; la lista se llena de forma asíncrona |
voiceschanged todavía no se disparó | No es definitivo; el evento puede llegar aún |
Una lectura tras voiceschanged no está vacía | La lista está lista para usarse |
| El tiempo de espera expira con la lista vacía | No aparecieron voces durante tu espera; no prueba que no existan |
La diferencia entre «todavía no» y «no hay» decide si la interfaz muestra un indicador de carga, un reintento o un mensaje de idioma, y ambas situaciones se ven idénticas en una sola llamada a getVoices(). Tres preguntas las separan sin adivinar.
Lee una vez al cargar y conserva ese resultado. Un array vacío en el primer renderizado es normal en algunas plataformas, porque la lista se llena de forma asíncrona. Regístralo como la primera muestra y no como un veredicto, y muestra el selector en estado de carga.
Vincula exactamente un listener de voiceschanged mientras viva el componente y vuelve a leer dentro de él. Una lectura no vacía significa que la lista está lista. Una lectura igual a la primera solo indica que el evento se disparó con la lista aún vacía; la plataforma no promete nada ahí, así que trátalo como «sigue vacía» y no como «no hay ninguna».
Acota la espera con un tiempo de espera de la aplicación y trátalo como un estado, no como un fallo. Cuando expire con una lista vacía, quita el listener, limpia el temporizador, detén el indicador y muestra el mensaje de idioma con el texto todavía legible y un botón de reintento. Una página que espera para siempre, o que conserva un listener obsoleto, ha convertido un detalle de plataforma en un control inutilizable.
const readOnce = () => speechSynthesis.getVoices();
const key = list => list.map(v => `${v.voiceURI}|${v.lang}|${v.name}`).join('\n');
let first = readOnce();
let settled = false;

const settle = new Promise(resolve => {
  const finish = outcome => {
    if (settled) return;
    settled = true;
    clearTimeout(timer);
    speechSynthesis.removeEventListener('voiceschanged', onChange);
    resolve(outcome);
  };
  const timer = setTimeout(() => finish('still-empty'), 2000);
  const onChange = () => {
    const next = readOnce();
    // A change event with the same list proves the event fired, not that the list is final.
    if (next.length) finish('ready');
    else if (key(next) !== key(first)) finish('still-empty');
  };
  speechSynthesis.addEventListener('voiceschanged', onChange);
  if (first.length) finish('ready');
  // If no event arrives, the 2 s timer reports 'still-empty': neither ready nor proven absent.
});
Los tres desenlaces corresponden a tres pantallas distintas, y ninguna de ellas es «la síntesis de voz no es compatible». Una primera lectura no vacía va directa al selector. Una lectura tardía no vacía llega al selector después del estado de carga. Un tiempo de espera agotado con lectura vacía muestra el mensaje de idioma y conserva el texto. El mismo código produce los tres, así que la diferencia está en lo que informó la plataforma, no en lo que es el dispositivo.
Actualización y estados de la cola
El evento voiceschanged indica que cambió la lista que devuelve getVoices(). No ordena hablar de nuevo y la aplicación no debe asumir que se dispara exactamente una vez. Una rutina de actualización limpia sustituye la lista mostrada por el resultado de la llamada más reciente, elimina el listener de una sola ejecución cuando ya se utilizó y mantiene la preferencia de idioma de la persona separada de un objeto SpeechSynthesisVoice concreto. Si la aplicación permite reintentar manualmente, puede llamar a la misma rutina en vez de registrar otro manejador.
SpeechSynthesis.speak(utterance) agrega la locución a la cola del controlador. Los clics repetidos o las llamadas de actualización repetidas pueden producir voz duplicada si la interfaz no define su política. Un producto puede desactivar el botón de reproducción mientras haya una locución encolada o en curso, ofrecer una acción separada para detenerla o reemplazar deliberadamente la solicitud actual. Lo importante es hacer explícita esa transición. Un cambio en las opciones disponibles no debe crear por sí solo una entrada nueva en la cola.
El siguiente código es ilustrativo y no se ha ejecutado. Muestra una actualización acotada, coincidencia de idioma y una ruta de reproducción iniciada explícitamente por la persona. No garantiza que todos los navegadores expongan las mismas voces o acepten la reproducción en las mismas circunstancias.
Este ejemplo solo muestra la coincidencia automática de idioma; no implementa guardar ni restaurar una selección explícita de voz de la persona.
const synth = window.speechSynthesis;
const requestedLocale = 'en-GB'; // Set from the application's own locale.
let currentVoices = [];
let activeUtterance = null;
let refreshTimer = null;

function refreshVoices() {
  currentVoices = synth.getVoices();
  const exact = currentVoices.filter(voice => voice.lang.toLowerCase() === requestedLocale.toLowerCase());
  const language = requestedLocale.split('-')[0];
  const broader = currentVoices.filter(voice => voice.lang.toLowerCase().split('-')[0] === language.toLowerCase());
  return exact.length ? exact : broader;
}

function waitForVoices(onReady, timeoutMs = 1500) {
  const immediate = refreshVoices();
  if (immediate.length) {
    onReady(immediate);
    return;
  }

  const onChange = () => {
    const matches = refreshVoices();
    if (matches.length) {
      clearTimeout(refreshTimer);
      synth.removeEventListener('voiceschanged', onChange);
      onReady(matches);
    }
  };

  synth.addEventListener('voiceschanged', onChange);
  refreshTimer = setTimeout(() => {
    synth.removeEventListener('voiceschanged', onChange);
    refreshTimer = null;
    onReady(refreshVoices());
  }, timeoutMs);
}

function playFromUserAction(text) {
  const available = refreshVoices();
  const voice = available.find(item => item.default) ?? available[0];
  if (!voice) {
    showReadableRetryState();
    return;
  }

  const utterance = new SpeechSynthesisUtterance(text);
  utterance.lang = voice.lang;
  utterance.voice = voice;

  activeUtterance = utterance;
  utterance.onend = () => {
    activeUtterance = null;
  };
  utterance.onerror = () => {
    activeUtterance = null;
    showReadableRetryState();
  };
  synth.speak(utterance);
}

function stopSpeech() {
  synth.cancel();
  activeUtterance = null;
}
En un componente de producción, onReady debería actualizar un selector o un estado visible de disponibilidad, no serializar todas las voces en analíticas. El ejemplo también presupone que la aplicación implementa showReadableRetryState(). Una interfaz real debe impedir que los manejadores de eventos actualicen un componente ya desmontado, limpiar cualquier temporizador pendiente durante la limpieza y decidir qué hacer si se solicita otra reproducción mientras el habla está activa. Son decisiones normales del ciclo de vida; no se pueden deducir de los metadatos de voz.
Alternativas de idioma y activación del usuario
La selección de voz debe seguir la política de idioma de la aplicación, no una conjetura sobre el sistema operativo. Obtén el idioma solicitado del contenido o de un ajuste explícito de la aplicación. Prueba primero una coincidencia exacta, como en-GB. Si los requisitos del producto lo permiten, usa una coincidencia deliberada a nivel de idioma, como en-US. Si solo hay disponible un idioma no relacionado, no lo reproduzcas en silencio como si fuera equivalente. Mantén el texto visible y permite elegir otra opción o continuar sin voz.
El valor lang describe la voz y una locución también puede llevar una etiqueta de idioma. Ninguno traduce el texto. Una voz puede aparecer para un idioma y aun así pronunciar mal un nombre, una abreviatura o una frase con varios idiomas. Cuando haga falta, el producto debe usar texto traducido y controles de idioma comprensibles. El artículo sobre códecs WebRTC es otro ejemplo de una superficie de capacidades cuyas opciones anunciadas no deben confundirse con el resultado completo para la persona usuaria.
La salida de voz debe comenzar tras una acción deliberada, como pulsar «Leer en voz alta». Es una decisión de control de usuario y compatibilidad, no una afirmación de que la especificación Web Speech defina un diálogo de permisos universal. Las políticas del navegador y el contexto de incrustación pueden afectar al inicio del audio. La interfaz debe explicar cómo reintentar si la solicitud no comienza; no debe pedir que se conceda un permiso inexistente de la API ni afirmar que un clic garantiza que se oiga el audio.
Cuando la persona cambie el idioma de la aplicación, actualiza el idioma solicitado y vuelve a evaluar las opciones de la lista actual. Si la lista se actualiza mientras el menú está abierto, conserva la preferencia solo si todavía corresponde a una opción disponible. La aplicación puede etiquetar claramente la alternativa, por ejemplo: «Se usa inglés (Estados Unidos) porque no está disponible inglés (Reino Unido)». Una alternativa transparente es más fácil de corregir que un cambio automático oculto tras un botón genérico de reproducción.
La elección de la persona y los ajustes de accesibilidad deben mantenerse independientes de las analíticas. Quizá sea necesario guardar localmente una opción para la siguiente visita, pero eso no justifica enviar el array completo de voces a un servidor. Si un servicio envía texto a un proveedor remoto de síntesis, explica ese flujo de datos y sus controles por separado; localService por sí solo no debe presentarse como una auditoría completa del enrutamiento de red.
Cancelación, errores y límites de privacidad
La cola del controlador necesita un modelo de estados visible. Como mínimo, distingue entre no disponible, cargando, listo, en cola o hablando, completado, detenido y fallido. Un botón para detener debe llamar a cancel() y devolver la interfaz a un estado inactivo predecible; cancelar es una detención explícita, no una solicitud para reintentar. La etiqueta retryAvailable del diagrama significa que la aplicación puede ofrecer otro intento después de explicar un error, pero la reproducción debe esperar una nueva acción de la persona. Como la cancelación elimina locuciones pendientes además de interrumpir la actual, una página compartida debe considerar si un componente podría cancelar voz iniciada por otro. Coordina quién controla la cola en vez de dejar que cada widget manipule una cola global por su cuenta.
Asocia los manejadores de finalización y error a cada locución. Al finalizar, el control de reproducción puede volver al estado listo. Un error debe producir un mensaje comprensible, conservar el texto de origen y ofrecer un reintento o una alternativa útil. No repitas automáticamente speak() tras un error: las solicitudes reiteradas pueden acumularse en la cola o dejar a la persona sin saber si la aplicación recibió la orden de detenerse. Cuando se sustituya una locución, ignora las llamadas tardías de una solicitud antigua comparándola con la solicitud activa.
La Web Speech API expone eventos, pero la aplicación debe evitar prometer una única causa para todos los fallos. El problema puede deberse a una voz ausente, la disponibilidad del servicio, el texto, el contexto del navegador u otra condición específica de la plataforma. Comunica lo que la aplicación sabe, por ejemplo «No se inició la lectura» o «No hay una voz coincidente», y reserva los detalles técnicos para un diagnóstico de soporte voluntario. No deduzcas la identidad, el software instalado ni la ubicación de una persona a partir de un error o del nombre de una voz.
Para una solicitud normal de soporte, un registro compacto puede incluir el producto y la versión del navegador, el idioma de la aplicación, si había una voz coincidente y la categoría de error visible. Evita registrar la lista ordenada completa, cada voiceURI, las horas exactas de cada actualización o el contenido leído, salvo que exista un propósito de soporte definido y la persona haya dado su consentimiento. Conserva esos datos solo durante el caso indicado. El límite de privacidad consiste en minimizar los datos, no en ocultar un estado normal de la aplicación.
Este artículo no explica cómo identificar a una persona. Describe los metadatos como una superficie contextual potencial y se centra en un comportamiento fiable de la aplicación. La lista del navegador no demuestra por sí sola una identidad única, y un fixture ilustrativo local no permite establecer el comportamiento de todos los sistemas operativos, versiones de navegador, servicios lingüísticos o tecnologías de asistencia.
Qué aporta esta guía frente a la configuración
La guía de protección de Speech Synthesis describe los modos de voz de perfil y de sistema real de BotBrowser, sus indicadores de configuración y la resolución general de problemas de alineación del perfil. De forma predeterminada, --bot-speech-voices=profile usa los metadatos de voz del perfil; --bot-speech-voices=real usa las voces del sistema sin esa protección de metadatos. Ningún modo garantiza que el audio llegue a reproducirse. No ofrece un árbol de fallos para una aplicación de cara a la persona usuaria ante una primera lista vacía, una actualización mediante voiceschanged, una selección obsoleta o una cola de locuciones. Este artículo añade una regla de selección campo por campo, un ejemplo de aplicación no ejecutado y estados explícitos de interfaz para las alternativas de idioma, la reproducción iniciada por el usuario, la cancelación y los errores. Estos pasos complementan la guía de configuración; no afirman reproducir el comportamiento del perfil ni añaden una nueva garantía del producto.
Al diagnosticar un problema de configuración, separa dos preguntas: qué metadatos de voz devuelve la API del navegador y si el equipo anfitrión puede producir sonido audible para la persona prevista. Una guía de configuración o de perfiles puede describir la superficie declarada del navegador, mientras que la reproducción depende de la aplicación real y del contexto del equipo. Una enumeración correcta no es una prueba de audio. A la inversa, una solicitud de reproducción fallida no demuestra que la lista de voces sea incorrecta.
Preguntas frecuentes
¿Una primera llamada vacía significa que la síntesis de voz no es compatible?
No. Significa que la llamada actual no devolvió voces. La lista podría aparecer más tarde, el entorno podría no proporcionar ninguna o la API podría no estar disponible en ese contexto. Escucha voiceschanged durante un plazo acotado, ofrece reintentar y conserva el texto. No esperes indefinidamente ni deduzcas el tipo de dispositivo a partir de un resultado vacío.
¿Es voiceURI un identificador estable para guardar una preferencia?
Trátalo como metadato opaco de la implementación, no como una clave de cuenta portable. Es preferible guardar el idioma elegido por la persona y, si hace falta, una opción de presentación local que pueda compararse con la lista actual. Si una voz guardada ya no está disponible, pide una nueva elección en vez de cambiar en silencio a otro idioma.
¿localService: true demuestra que no interviene ningún servicio de red?
Describe el objeto de voz como local según la implementación. No audita todas las rutas del servicio ni demuestra que la aplicación completa mantenga el texto en el dispositivo. Explica por separado el flujo real de datos de la aplicación y no conviertas este valor booleano en una garantía amplia de privacidad.
¿Cada evento voiceschanged debe volver a iniciar la voz?
No. El evento indica que hay que actualizar las opciones disponibles; no expresa la intención de reproducir audio. Actualiza el selector, conserva o elimina la preferencia según la lista actual y requiere una acción de reproducción independiente.
Fuentes
- W3C Web Speech API: especificación de síntesis, objetos de voz, locuciones, métodos de cola y eventos.
- MDN: SpeechSynthesis: referencia del controlador y sus métodos para navegadores.
- MDN: SpeechSynthesis.getVoices(): método para obtener la lista de voces actual.
- MDN: SpeechSynthesisVoice: propiedades del objeto de voz.
- MDN: evento voiceschanged: evento de cambio de la lista.
- MDN: SpeechSynthesis.speak() y cancel(): comportamiento de la cola y cancelación.
- MDN: evento de error de SpeechSynthesisUtterance: evento de error de una locución.
- Protección de Speech Synthesis de BotBrowser: configuración del producto y límites de los modos de perfil.
Conclusión práctica
Una lista de voces vacía o cambiante es un estado de la aplicación que hay que gestionar, no una base para identificar a alguien ni para suponer una secuencia fija de plataforma. Actualiza con voiceschanged, elige entre los metadatos actuales según la política de idioma de la aplicación, inicia la voz tras una acción explícita de la persona y muestra la finalización, la cancelación y los errores. Conserva el texto legible y recopila solo los campos de diagnóstico necesarios para una tarea declarada. El siguiente paso seguro para un equipo de producto es probar listas inmediatas y demoradas, además de una locución fallida, en sus propios contextos de navegador compatibles, sin afirmar que este código o diagrama ilustrativo ya se haya ejecutado.
Este artículo forma parte de la guía: ¿Qué es la huella digital del navegador?
Artículos Relacionados
Voces de síntesis de voz y reproducción accesible en el navegador
Huella digitalFingerprinting de codecs WebRTC: fuga de capacidades
Huella digitalInformación del adaptador WebGPU y privacidad del usuario
Huella digitalFingerprinting por medicion de texto: rastreo subpixel
Huella digitalHuella de tasa de cuadros: frecuencia de pantalla y vídeo
Huella digital¿Qué es la huella de fuentes? Coherencia de texto entre plataformas
Lleva BotBrowser de la investigación a producción
Usa estas guías para entender el modelo y después avanzar hacia validación multiplataforma, contextos aislados y despliegue de navegador preparado para escalar.