Evaluar la coherencia del navegador antes del despliegue
Evaluación práctica para validar perfiles de navegador, hosts, coste de ejecución y responsables del lanzamiento entre plataformas.
BotBrowser Team
Quieres la documentación estructurada de Plataforma?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
Empieza por la decisión de despliegue
La coherencia del navegador entre plataformas es una cuestión de despliegue, no solo de comparar funciones. Antes de elegir un plan o trasladar un flujo de trabajo a producción, deja por escrito la plataforma objetivo, los sistemas operativos host, el modo del navegador y la carga de trabajo que debe mantenerse estable.
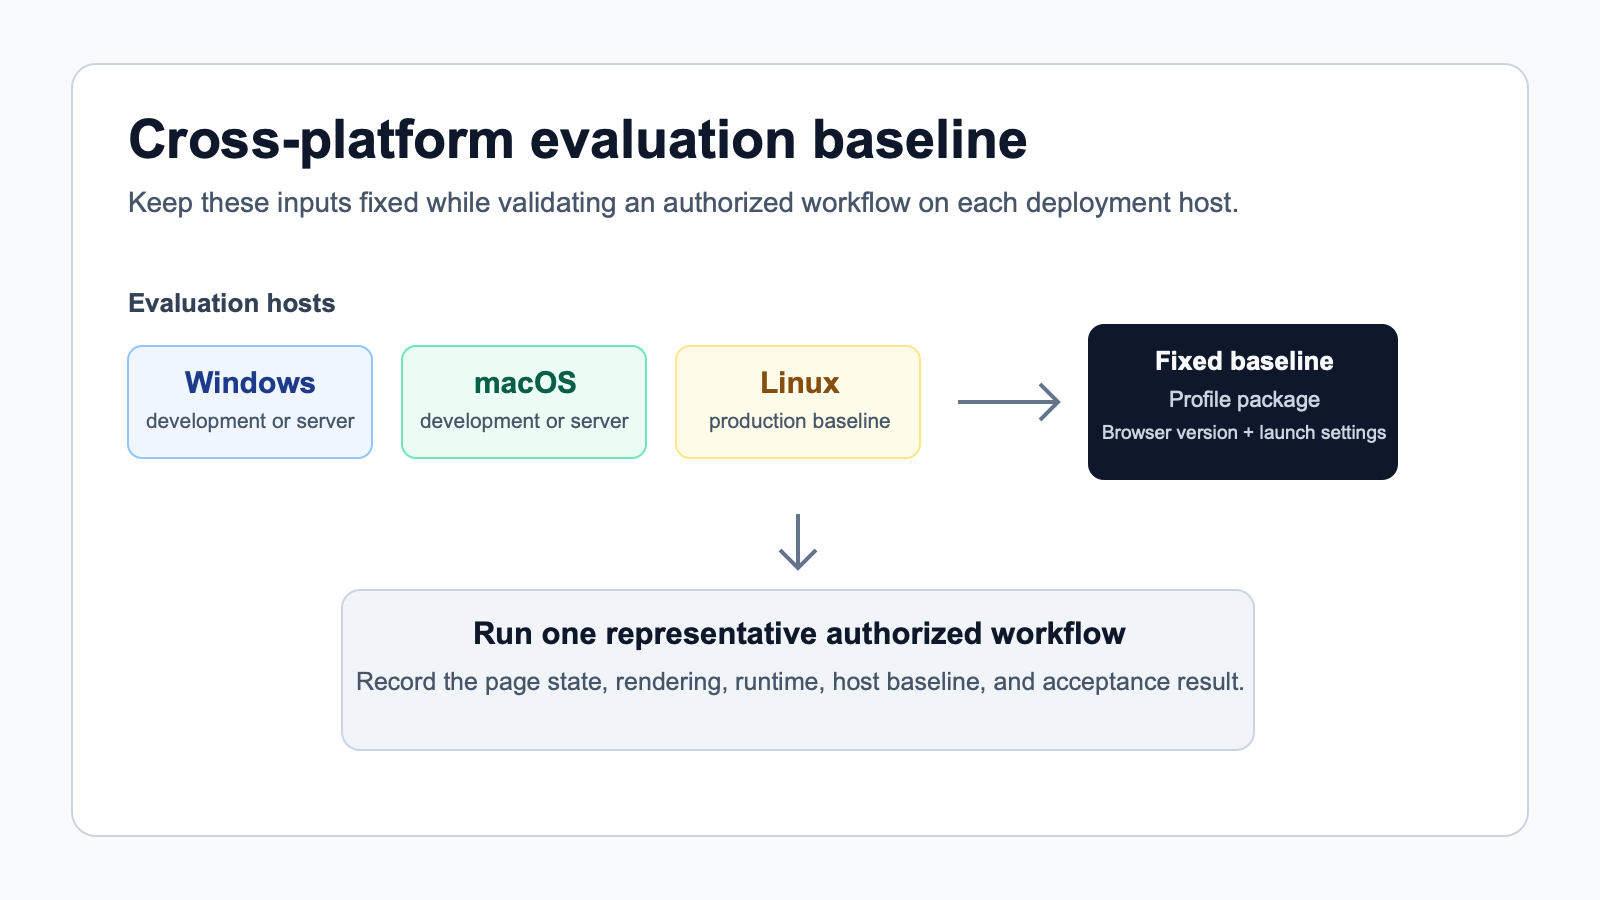
Las combinaciones compatibles son amplias. La documentación de perfiles entre plataformas enumera hosts Windows, macOS y Linux para perfiles objetivo Windows, macOS y Android. Los hosts Linux requieren ENT Tier 1. La misma página también recomienda comprobar la versión de BotBrowser, el archivo de perfil y la configuración de lanzamiento cuando la salida difiere entre hosts.
Esa matriz es un punto de partida. No sustituye una prueba de tu propio flujo de trabajo autorizado.
Comprueba la matriz de host y objetivo
Haz explícita la matriz de compatibilidad antes de comparar proveedores o planes. Registra cada perfil objetivo y cada host que lo ejecutará. Incluye la clase de host de producción, no solo la estación de trabajo del equipo de evaluación.
Por ejemplo, un equipo puede necesitar un perfil objetivo Windows en macOS para desarrollo, el mismo perfil en Linux para un despliegue en servidor y un perfil objetivo Android en Windows para un flujo de validación. Cada combinación debe tener un responsable y un resultado de prueba.
Linux merece una comprobación de preparación independiente. La documentación de configuración de servidores headless especifica Ubuntu 20.04 o posterior, x86_64 o arm64, el binario Ubuntu de BotBrowser, un paquete de perfil de producción compatible y acceso root o sudo para instalar los paquetes del sistema. Los binarios de Ubuntu y Linux requieren ENT Tier 1 o superior.
El servidor también necesita las bibliotecas del sistema documentadas y una pantalla virtual. La configuración pública usa Xvfb y DISPLAY=:10.0, incluso en operación headless. Trata ambos elementos como requisitos previos del lanzamiento. Un host que no pueda reproducir la base de pantalla y de bibliotecas del sistema no está listo para una decisión de coherencia.
Valida la base headless
La evaluación del servidor debe realizarse en un host parecido al de producción. La documentación de configuración headless señala bibliotecas compartidas para renderizado, audio, red y accesibilidad, además de fuentes y aspectos del renderizado por GPU. La falta de paquetes o una pantalla mal configurada puede afectar al inicio, las capturas, el renderizado de caracteres o el comportamiento multimedia. La guía de configuración de servidores headless recorre los mismos requisitos con más detalle.
Usa la configuración de servidor documentada como base y después prueba el flujo representativo. Comprueba también el paquete de perfil seleccionado. La guía pública indica que propiedades de identidad como la resolución de pantalla, las fuentes y la información de GPU proceden del perfil, no del hardware del servidor. Es un comportamiento que cada equipo debe verificar en su propio entorno.
Mantén los detalles operativos bajo responsabilidad clara. Una persona debe encargarse del paquete de perfil, otra de la imagen del host y sus dependencias del sistema, y otra del registro de aceptación del flujo. Este reparto facilita investigar una incoherencia posterior sin cambiar varias variables a la vez.
Ejecuta un flujo de trabajo representativo
Una evaluación útil tiene un objeto claro. Elige un flujo de trabajo autorizado que represente la ruta de producción y ejecútalo en cada combinación importante de host y objetivo.
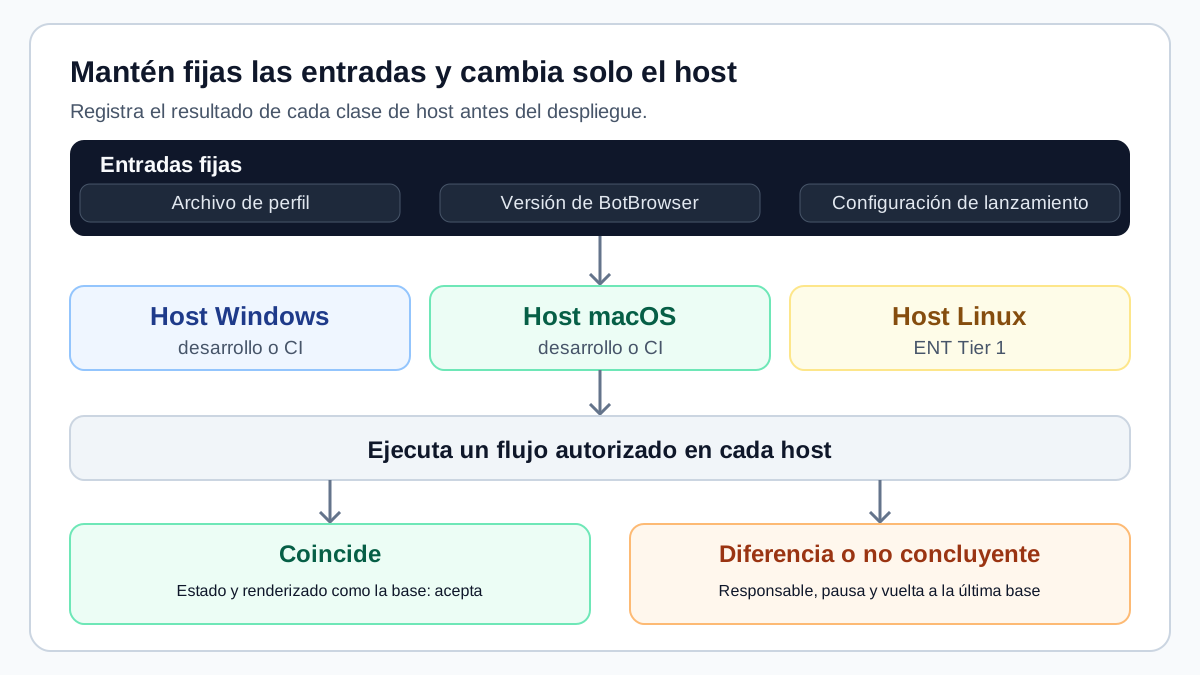
Mantén fijos el artefacto de perfil, la versión de BotBrowser, la configuración de lanzamiento, el modo del navegador y los pasos del flujo mientras cambias el host. La documentación entre plataformas describe el perfil como la fuente de identidad y recomienda ejecutar el mismo perfil en ejecutores Windows, macOS y Linux para compararlos.
Registra los resultados observables en cada paso. Confirma que el flujo alcanza el estado de página esperado, que las capturas y el renderizado se comportan como se espera y que las principales familias de señales del navegador siguen siendo coherentes para el objetivo seleccionado. No uses una sola propiedad como prueba de aceptación. Un arranque correcto por sí solo tampoco basta.
Repite la prueba más de una vez cuando el flujo sea sensible a las condiciones de inicio o de renderizado. Conserva la evidencia junto con el registro del lanzamiento para poder comparar un cambio posterior de host o de versión con el resultado original.
Define un registro de aceptación antes de probar
El registro de evaluación convierte una demostración exitosa en una decisión operativa. Escríbelo antes de la primera ejecución, mientras el equipo aún puede acordar qué importa. Debe identificar el flujo, a su responsable, el perfil objetivo previsto y la clase de host evaluada. También debe describir en lenguaje claro el estado de página esperado. Para un equipo puede ser llegar a un espacio de trabajo autenticado; para otro, completar una transacción interna admitida o generar un informe necesario.
Mantén la redacción de la aceptación observable. "El flujo terminó y se alcanzó el estado de página esperado" es útil. "Parecía normal" no lo es. Registra la página o el estado que confirma el resultado, las condiciones de la ejecución y las dependencias conocidas, como una cuenta de prueba, una ruta de proxy aprobada o un servicio interno. El objetivo es la repetibilidad, no una colección de capturas aisladas.
Separa los resultados obligatorios de las observaciones útiles. Un resultado obligatorio es una condición que debe cumplirse antes de que el flujo avance. Una observación útil puede ayudar a entender un resultado, pero no debe convertirse en silencio en una nueva condición de aprobación. Esta distinción evita que la prueba crezca cada vez que alguien detecta otra variable. También permite explicar el resultado a una persona de ingeniería, operaciones o compras que no ejecutó la prueba.
Usa el mismo registro en todos los entornos host. Entre ejecuciones solo deben cambiar los campos propios del host. Así resulta más fácil identificar una diferencia relevante: una versión distinta, una dependencia ausente, una base de pantalla modificada o una condición del flujo que no se mantuvo constante. Si cambia un resultado, resiste la tentación de modificar varios ajustes a la vez. Registra la diferencia, restaura la base conocida y aísla una variable cada vez.
El registro también debe indicar dónde está la evidencia. Guarda juntas las capturas, la salida relevante de la aplicación y la decisión de aprobación. Un lugar compartido importa cuando quien hizo la evaluación ya no está disponible. Da a la siguiente persona un punto de partida defendible, en lugar de pedirle que reconstruya de memoria un entorno sin documentar.
Separa la preparación del host de la del perfil
La preparación del perfil y la del host responden a preguntas distintas. El paquete de perfil determina la identidad del navegador seleccionada. La preparación del host determina si el entorno puede iniciar y renderizar el flujo autorizado de forma consistente. Tratarlas como una sola tarea complica las investigaciones, porque un problema del host puede confundirse con uno del perfil, o al revés.
Empieza por el host. Confirma la familia del sistema operativo, la arquitectura, las dependencias de ejecución, la configuración de pantalla, la ubicación del almacenamiento y la política de red. En un despliegue Linux, usa la base headless documentada como fuente de verdad en lugar de adaptar una receta de estación de trabajo local. En un host de escritorio, documenta lo esencial de la misma manera para poder repetir la evaluación cuando se sustituya o reconfigure la máquina.
Después establece la preparación del perfil. Confirma que el paquete de perfil, la versión de BotBrowser y la plataforma objetivo corresponden al flujo previsto. No lo deduzcas solo por el nombre de un archivo. Registra el identificador del paquete y la versión del navegador usada en la prueba. Si el flujo requiere estado persistente, registra también quién lo posee y cómo se aísla. Una comprobación correcta no debe depender de una caché accidental, de un directorio de datos desconocido ni de una sesión previa que no se pueda reproducir.
Por último, evalúa la conexión entre ambos. Ejecuta el mismo perfil aprobado con los mismos ajustes de lanzamiento en cada clase de host relevante para el despliegue. Una diferencia en este punto es accionable porque las entradas están claras. El equipo puede decidir si corrige la base del host, usa otro host compatible o cambia la secuencia del lanzamiento. Tomar esa decisión durante la evaluación cuesta mucho menos que hacerlo cuando ya ha empezado un despliegue más amplio.
Planifica la evaluación como un lanzamiento controlado
La evaluación entre plataformas se beneficia de una secuencia deliberada. Empieza por el entorno más pequeño que represente la operación prevista. Confirma allí el flujo y la base antes de añadir otro host, otro perfil objetivo u otro modo del navegador. El objetivo no es maximizar la cobertura el primer día, sino establecer un punto de referencia fiable con el que comparar los resultados posteriores.
Amplía por límites operativos con significado. Un nuevo sistema operativo host, una nueva imagen de despliegue, un ejecutor headless o un nuevo perfil objetivo son límites útiles porque cada uno puede cambiar las condiciones prácticas del flujo. Añade un límite, repite el registro de aceptación y conserva el resultado. Así queda un historial claro de lo validado y de lo que sigue siendo una suposición.
Define una condición de pausa antes de empezar. Puede ser un estado de página inesperado, un renderizado que impida trabajar, la imposibilidad de reproducir el registro aprobado o un entorno al que le falte un requisito documentado. Cuando ocurra, detén la ampliación de la evaluación y vuelve a la última base aceptada. Es un control operativo normal, no un fallo del producto ni del equipo.
El mismo enfoque ayuda cuando un resultado no es concluyente. Márcalo como no concluyente en lugar de tratarlo como aprobado o de explicarlo con afirmaciones sin verificar. Registra lo observado, conserva los detalles del entorno y asigna un responsable para la siguiente comprobación. Una incertidumbre clara es más útil que una falsa certeza cuando de la respuesta depende una suscripción o un lanzamiento a producción.
Conecta el plan con el modelo operativo
El plan adecuado lo determina el flujo validado, no una lista genérica de funciones. Parte de las plataformas objetivo, las clases de host, el modo de operación y el número de identidades de navegador que el equipo gestiona de forma independiente. Después confirma qué capacidad de BotBrowser admite ese modelo operativo y si el derecho correspondiente está incluido en el plan elegido.
Para una validación pequeña, el resultado importante puede ser un perfil repetible y una base de escritorio o de servidor aprobada. Para una operación más amplia, la pregunta puede pasar a cómo mantienen los equipos los paquetes de perfil, documentan los cambios y alinean varios entornos. Las capacidades Per-Context son relevantes cuando el flujo está pensado para gestionar identidades de perfil separadas dentro de una operación de navegador compartida, pero el benchmark público debe tratarse como evidencia de referencia, no como una promesa de dimensionamiento.
Mantén la decisión comercial cerca de la evidencia. La página de precios describe los planes disponibles, mientras que el registro de despliegue explica por qué un equipo necesita una capacidad concreta. Esta conexión hace más útil la conversación comercial: el equipo puede hablar de un flujo real, del alcance de plataformas aceptado y de la responsabilidad operativa que implica. También evita elegir un plan basándose solo en una carga futura hipotética.
Cuando cambie la operación prevista, revisa la decisión. Una nueva familia de hosts, otra plataforma objetivo o el paso de un flujo interactivo a uno de servidor pueden exigir una evaluación nueva. Reutilizar el registro original da ventaja de partida, pero no acepta automáticamente la nueva condición.
Compara el coste de ejecución con la evidencia publicada
El rendimiento debe medirse frente a la carga y la escala que piensas operar. El BotBrowser Performance Benchmark informa de resultados para comparaciones definidas en modo headful y headless. También cubre grupos seleccionados de las API Canvas, WebGL, Navigator, Screen y Font en entornos de prueba macOS, Linux y Windows.
Esos resultados son referencias útiles, no una promesa para todos los hosts. La metodología del benchmark utiliza hardware, versiones del navegador, modos y ejecuciones repetidas definidos. Tu evaluación debe registrar el mismo tipo de variables y comparar condiciones equivalentes.
Si el despliegue usa muchos perfiles a la vez, compara también el modelo operativo, no solo la velocidad de una sesión. La comparación de escala publicada contrapone la operación Per-Context con instancias de navegador separadas bajo una carga definida. Per-Context Fingerprint es una opción de ENT Tier. Confirma que tu plan incluye ese derecho y que el flujo encaja antes de usar la evidencia del benchmark en una estimación de capacidad. El artículo sobre planificación de capacidad explica cómo convertir las mediciones en presupuestos de host.
Convierte las mediciones en un modelo de costes. Registra el número de hosts, el margen de memoria, la densidad de procesos, el tiempo de inicio y la cantidad de perfiles concurrentes que requiere el flujo. Después calcula el precio de la capacidad necesaria con los planes actuales de BotBrowser. Una cifra de benchmark menor solo es útil cuando reduce los recursos que tu lanzamiento necesita de verdad.
Conserva una base versionada
La coherencia entre plataformas depende de más que el nombre de un perfil. Guarda la versión de BotBrowser, la versión o el identificador del paquete de perfil, la plataforma objetivo, el sistema operativo y la arquitectura del host, el modo headless o headful, la configuración de pantalla y la revisión del flujo usada para la aceptación.
La documentación entre plataformas indica de forma expresa que deben coincidir la versión de BotBrowser, el archivo de perfil y la configuración de lanzamiento cuando las salidas difieren. Haz obligatorios esos campos en el registro de evaluación. Incluye la fecha, el tiempo de ejecución medido y los enlaces a la evidencia.
Este registro crea un punto de reversión útil. Cuando cambie la imagen del host, el paquete de perfil o la versión del navegador, vuelve a ejecutar el mismo flujo y compáralo con la base aprobada. Conserva el registro anterior hasta aceptar el nuevo resultado.
Revisa los cambios sin perder la base
Los cambios son normales en un despliegue de navegador. Los hosts reciben actualizaciones, los paquetes de perfil evolucionan, las versiones del navegador avanzan y los flujos incorporan páginas o dependencias nuevas. La cuestión operativa no es si habrá cambios, sino si el equipo puede reconocer cuál ocurrió y decidir si el resultado aprobado sigue siendo válido.
Define qué cambios requieren un nuevo registro de evaluación. Sustituir un paquete de perfil, cambiar la versión del navegador, usar una nueva imagen de host, modificar la configuración de pantalla o revisar de forma material el flujo son ejemplos habituales. Centra el activador en una condición operativa, no en cada observación menor. La regla resultante debe ser fácil de seguir en un lanzamiento rutinario.
Cuando haya un cambio, conserva el registro anterior y crea una nueva entrada de comparación. Explica qué cambió, quién aprobó la nueva ejecución y si la base previa sigue siendo válida para un despliegue existente. Así el rollback sigue siendo práctico y se evita una fuente común de fricción con el soporte: varios equipos convencidos de usar la misma configuración mientras sus imágenes de host o paquetes de perfil ya han divergido. El artículo sobre validación de versiones del navegador describe una rutina relacionada para los cambios de versión.
Usa una nota de revisión breve para cada decisión de aceptación. Debe indicar qué se probó, qué evidencia se revisó, qué queda fuera del alcance probado y quién es responsable de la siguiente acción. Esa nota es valiosa cuando varias personas interesadas evalúan una suscripción. Convierte una afirmación amplia sobre compatibilidad de plataformas en un resultado acotado que operaciones puede usar de verdad.
Asigna responsables del lanzamiento
Una evaluación de despliegue termina cuando la decisión operativa está clara. Nombra a la persona o al equipo que aprueba los cambios de perfil, al equipo que mantiene las dependencias del servidor y al responsable de la prueba del flujo. Define quién puede pausar un lanzamiento cuando un host produce resultados incoherentes.
Empieza con un despliegue limitado que cubra las combinaciones representativas. Amplíalo solo después de registrar el mismo perfil, versión, base del host y resultado del flujo para cada nuevo entorno. Así, un cambio de plataforma no se convierte en una variable de producción sin seguimiento.
La compatibilidad entre plataformas puede reducir la necesidad de reconstruir un flujo para cada host, pero la decisión de compra sigue necesitando evidencia. Comprueba la matriz, reproduce el flujo autorizado, compara el coste de ejecución con el benchmark publicado, conserva la base y asigna responsables antes del despliegue.
BotBrowser respalda esta evaluación al aplicar las propiedades de identidad del perfil seleccionado, entre ellas el agente de usuario, la pantalla, las fuentes, la GPU y la pila de idiomas, de modo que el mismo archivo de perfil puede ejecutarse en hosts Windows, macOS y Linux. Con la misma versión de BotBrowser y la misma configuración de lanzamiento, tu equipo puede comparar las salidas entre hosts sin reconstruir el flujo para cada uno. BotBrowser no puede garantizar resultados idénticos en todos los hosts ni sitios, y no sustituye la validación de tu propio flujo autorizado en hosts representativos. Tampoco controla las dependencias del host, la configuración de pantalla ni cómo un sitio web interpreta las señales del navegador, y los hosts Linux requieren ENT Tier 1.
El resultado es una decisión de despliegue que se puede revisar, repetir y mejorar a medida que cambia el entorno. Ofrece a las personas técnicas y comerciales la misma referencia práctica: un flujo autorizado, un alcance de hosts definido y evidencia que pertenece a la operación en lugar de a una suposición.
Fuentes públicas
Artículos Relacionados
Lleva BotBrowser de la investigación a producción
Usa estas guías para entender el modelo y después avanzar hacia validación multiplataforma, contextos aislados y despliegue de navegador preparado para escalar.